Análisis de Datos Reproducible con R y Quarto
Introducción

Intro
Intro
¿Qué es un análisis de datos reproducible?
¿Qué es Quarto?
Empecemos con Quarto
Crear un reporte en Quarto
Iterando sus reportes
Dele estilo a sus reportes
Usar otros formatos
Usar co-pilot en R
¡Muchas gracias!
¿Qué vamos a hacer en estos dos días?
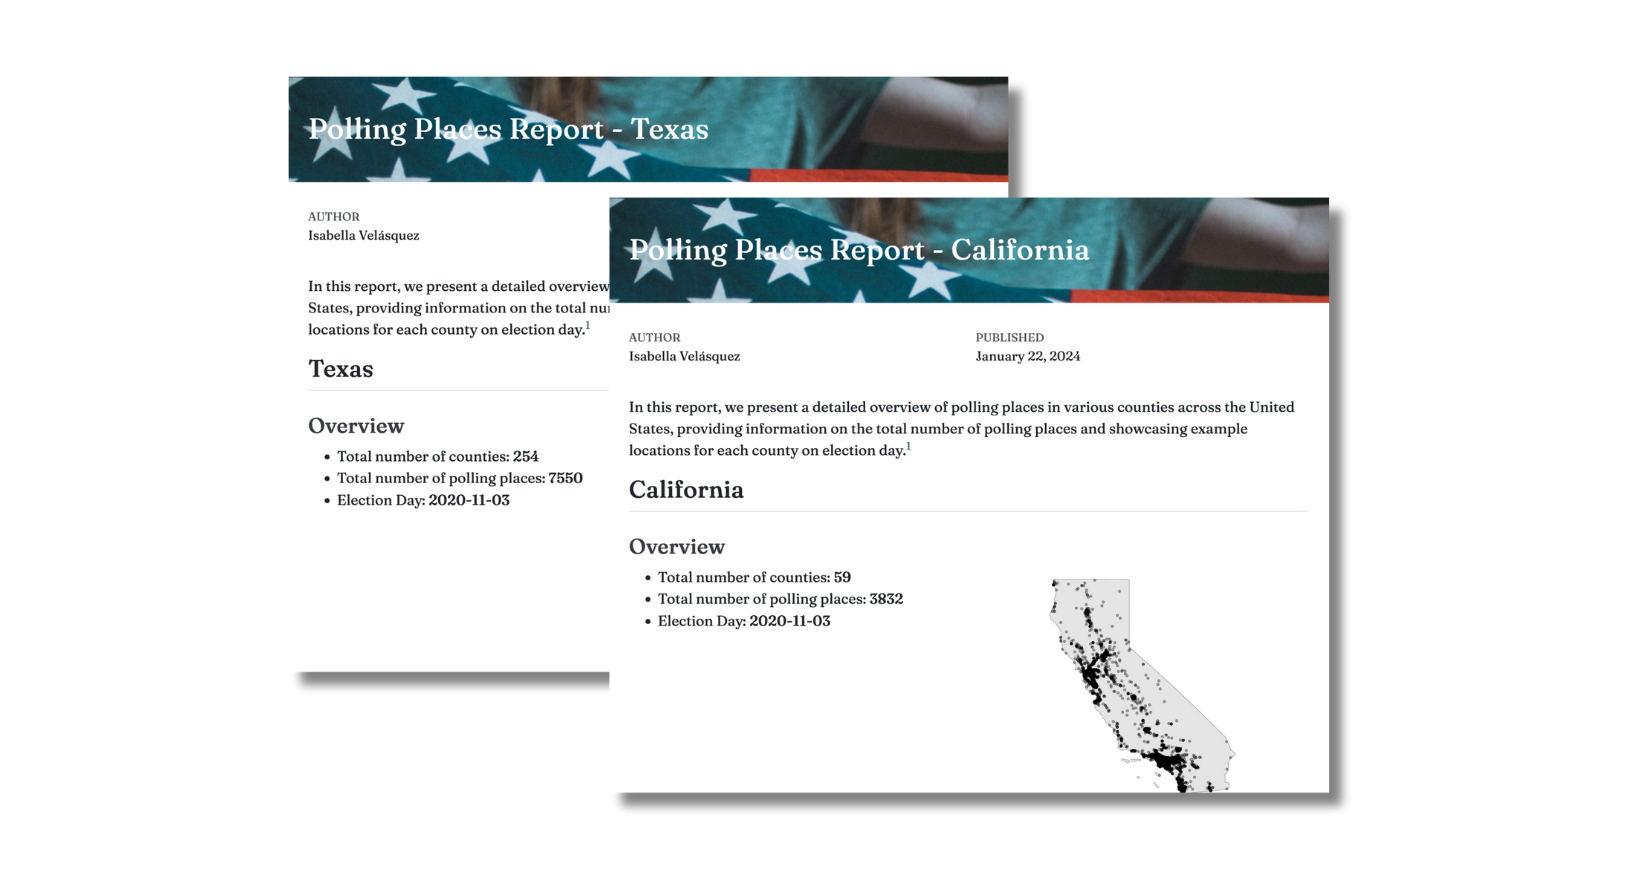
Data
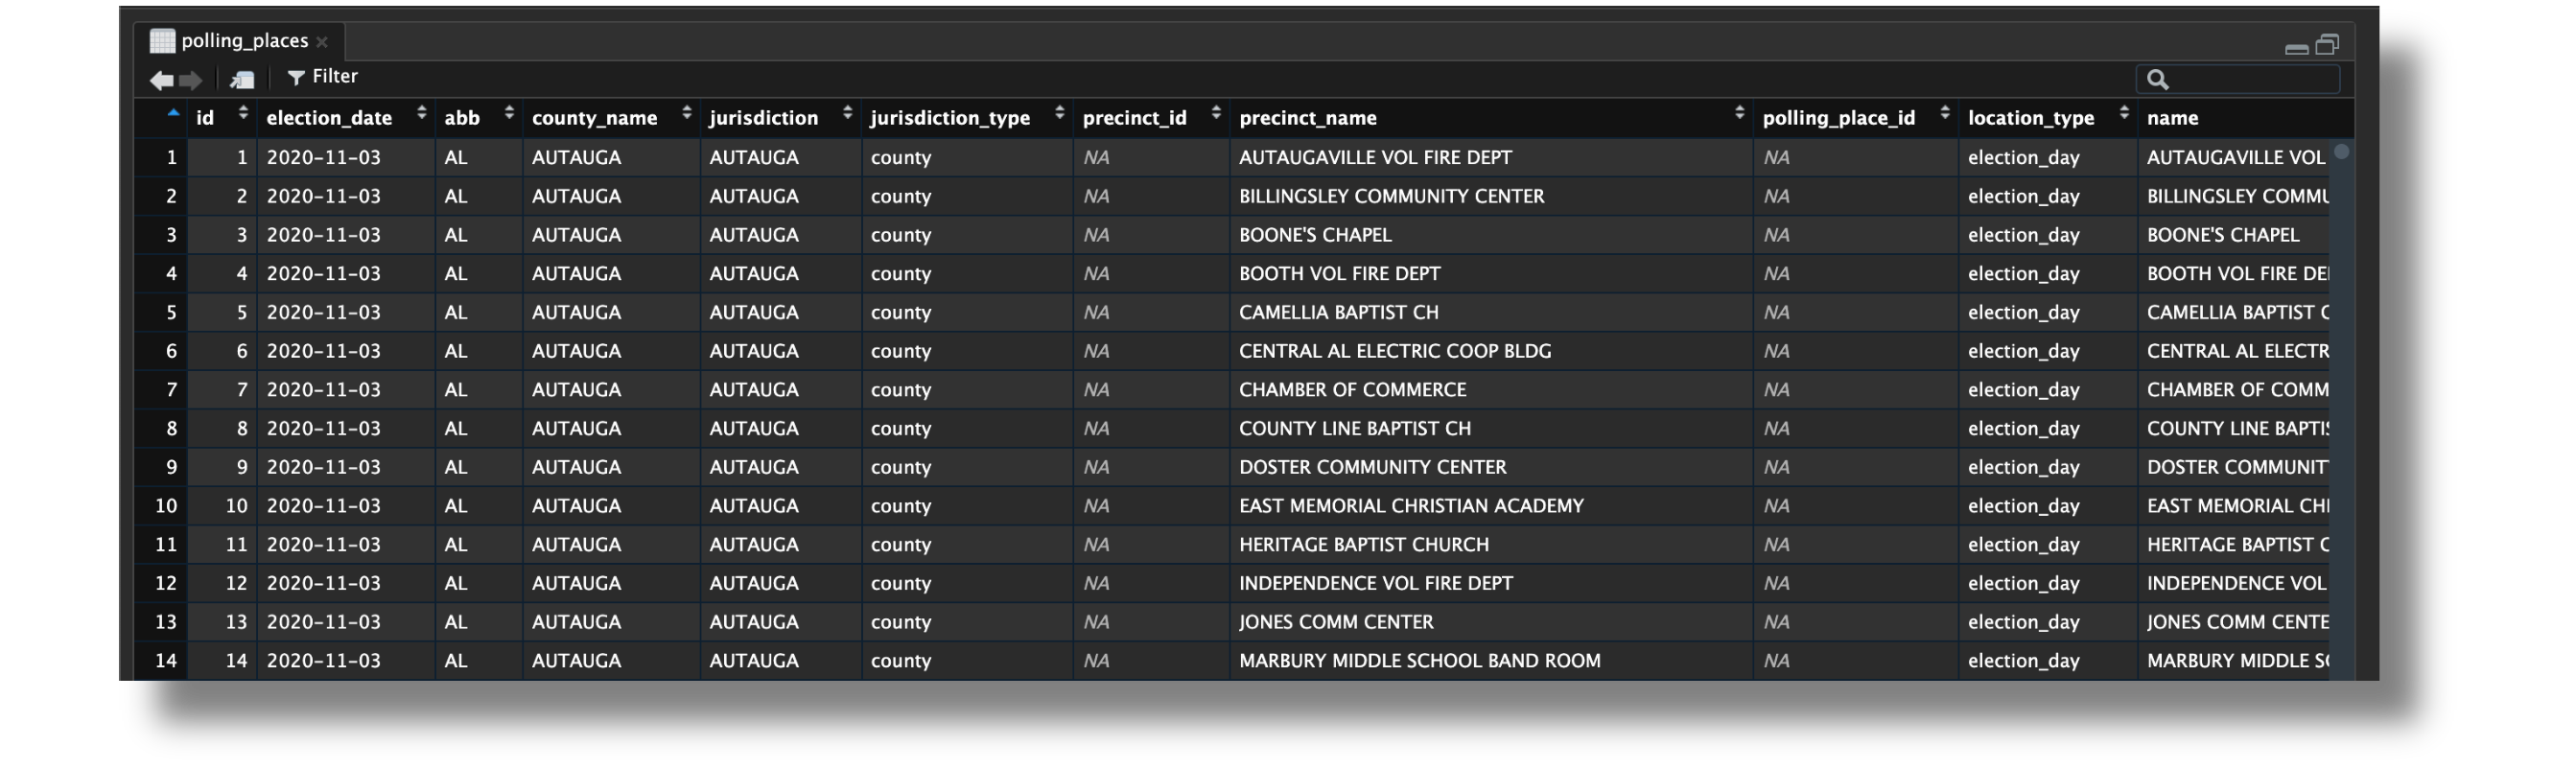
Utilizaremos los datos de TidyTuesday acerca de lugares de votación en los Estados Unidos: días de elecciones, locaciones, direcciones, y otros puntos.
- Usaremos el análisis hecho por @thedivtagguy y el reporte reproducible de Isabella Velásquez
 ## Antes de iniciar
- Descargue o actualice Quarto, R, RStudio (v2023.06 o más), y git en su computadora.
- Cree una cuenta en Github, si ya la tiene tenga su usuario y contraseña a mano para el curso.
- Descargue e instale Copilot agent desde su R Studio.
Native base R pipe |>
- Incluida después de R 4.1.0
- Similar al pipe de magrittr
¿Qué es un análisis de datos reproducible?
Intro
¿Qué es un análisis de datos reproducible?
¿Qué es Quarto?
Empecemos con Quarto
Crear un reporte en Quarto
Iterando sus reportes
Dele estilo a sus reportes
Usar otros formatos
Usar co-pilot en R
¡Muchas gracias!
¿Qué significa investigación reproducible?
“Reproducibilidad significa que los datos de investigación y el código están disponibles para que otros puedan alcanzar los mismos resultados que se afirman en los productos científicos. Estrechamente relacionado está el concepto de replicabilidad, el acto de repetir una metodología científica para llegar a conclusiones similares.”
Fuente: Foster Open Science. https://book.fosteropenscience.eu/en/
¿Qué significa investigación reproducible?
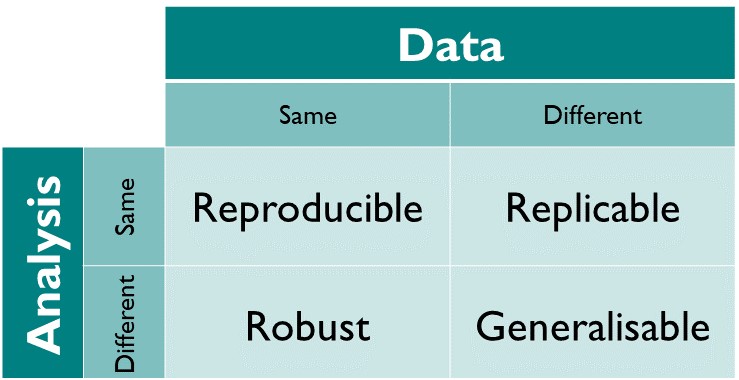
Fuente: The Turing Way project.
Definiciones
Datos: originales, y en versión adecuada para el tipo de análisis. Archivos de formato abierto, y con metadatos de calidad.
Código: scripts con el código para extraer, limpiar y analizar los datos, y además, producir el reporte y las figuras correspondientes.
Herramientas: lenguaje, paquetes, ambiente para reproducir el análisis.
Resultados: figuras, tablas, reportes, presentaciones, dashboards.
Definiciones
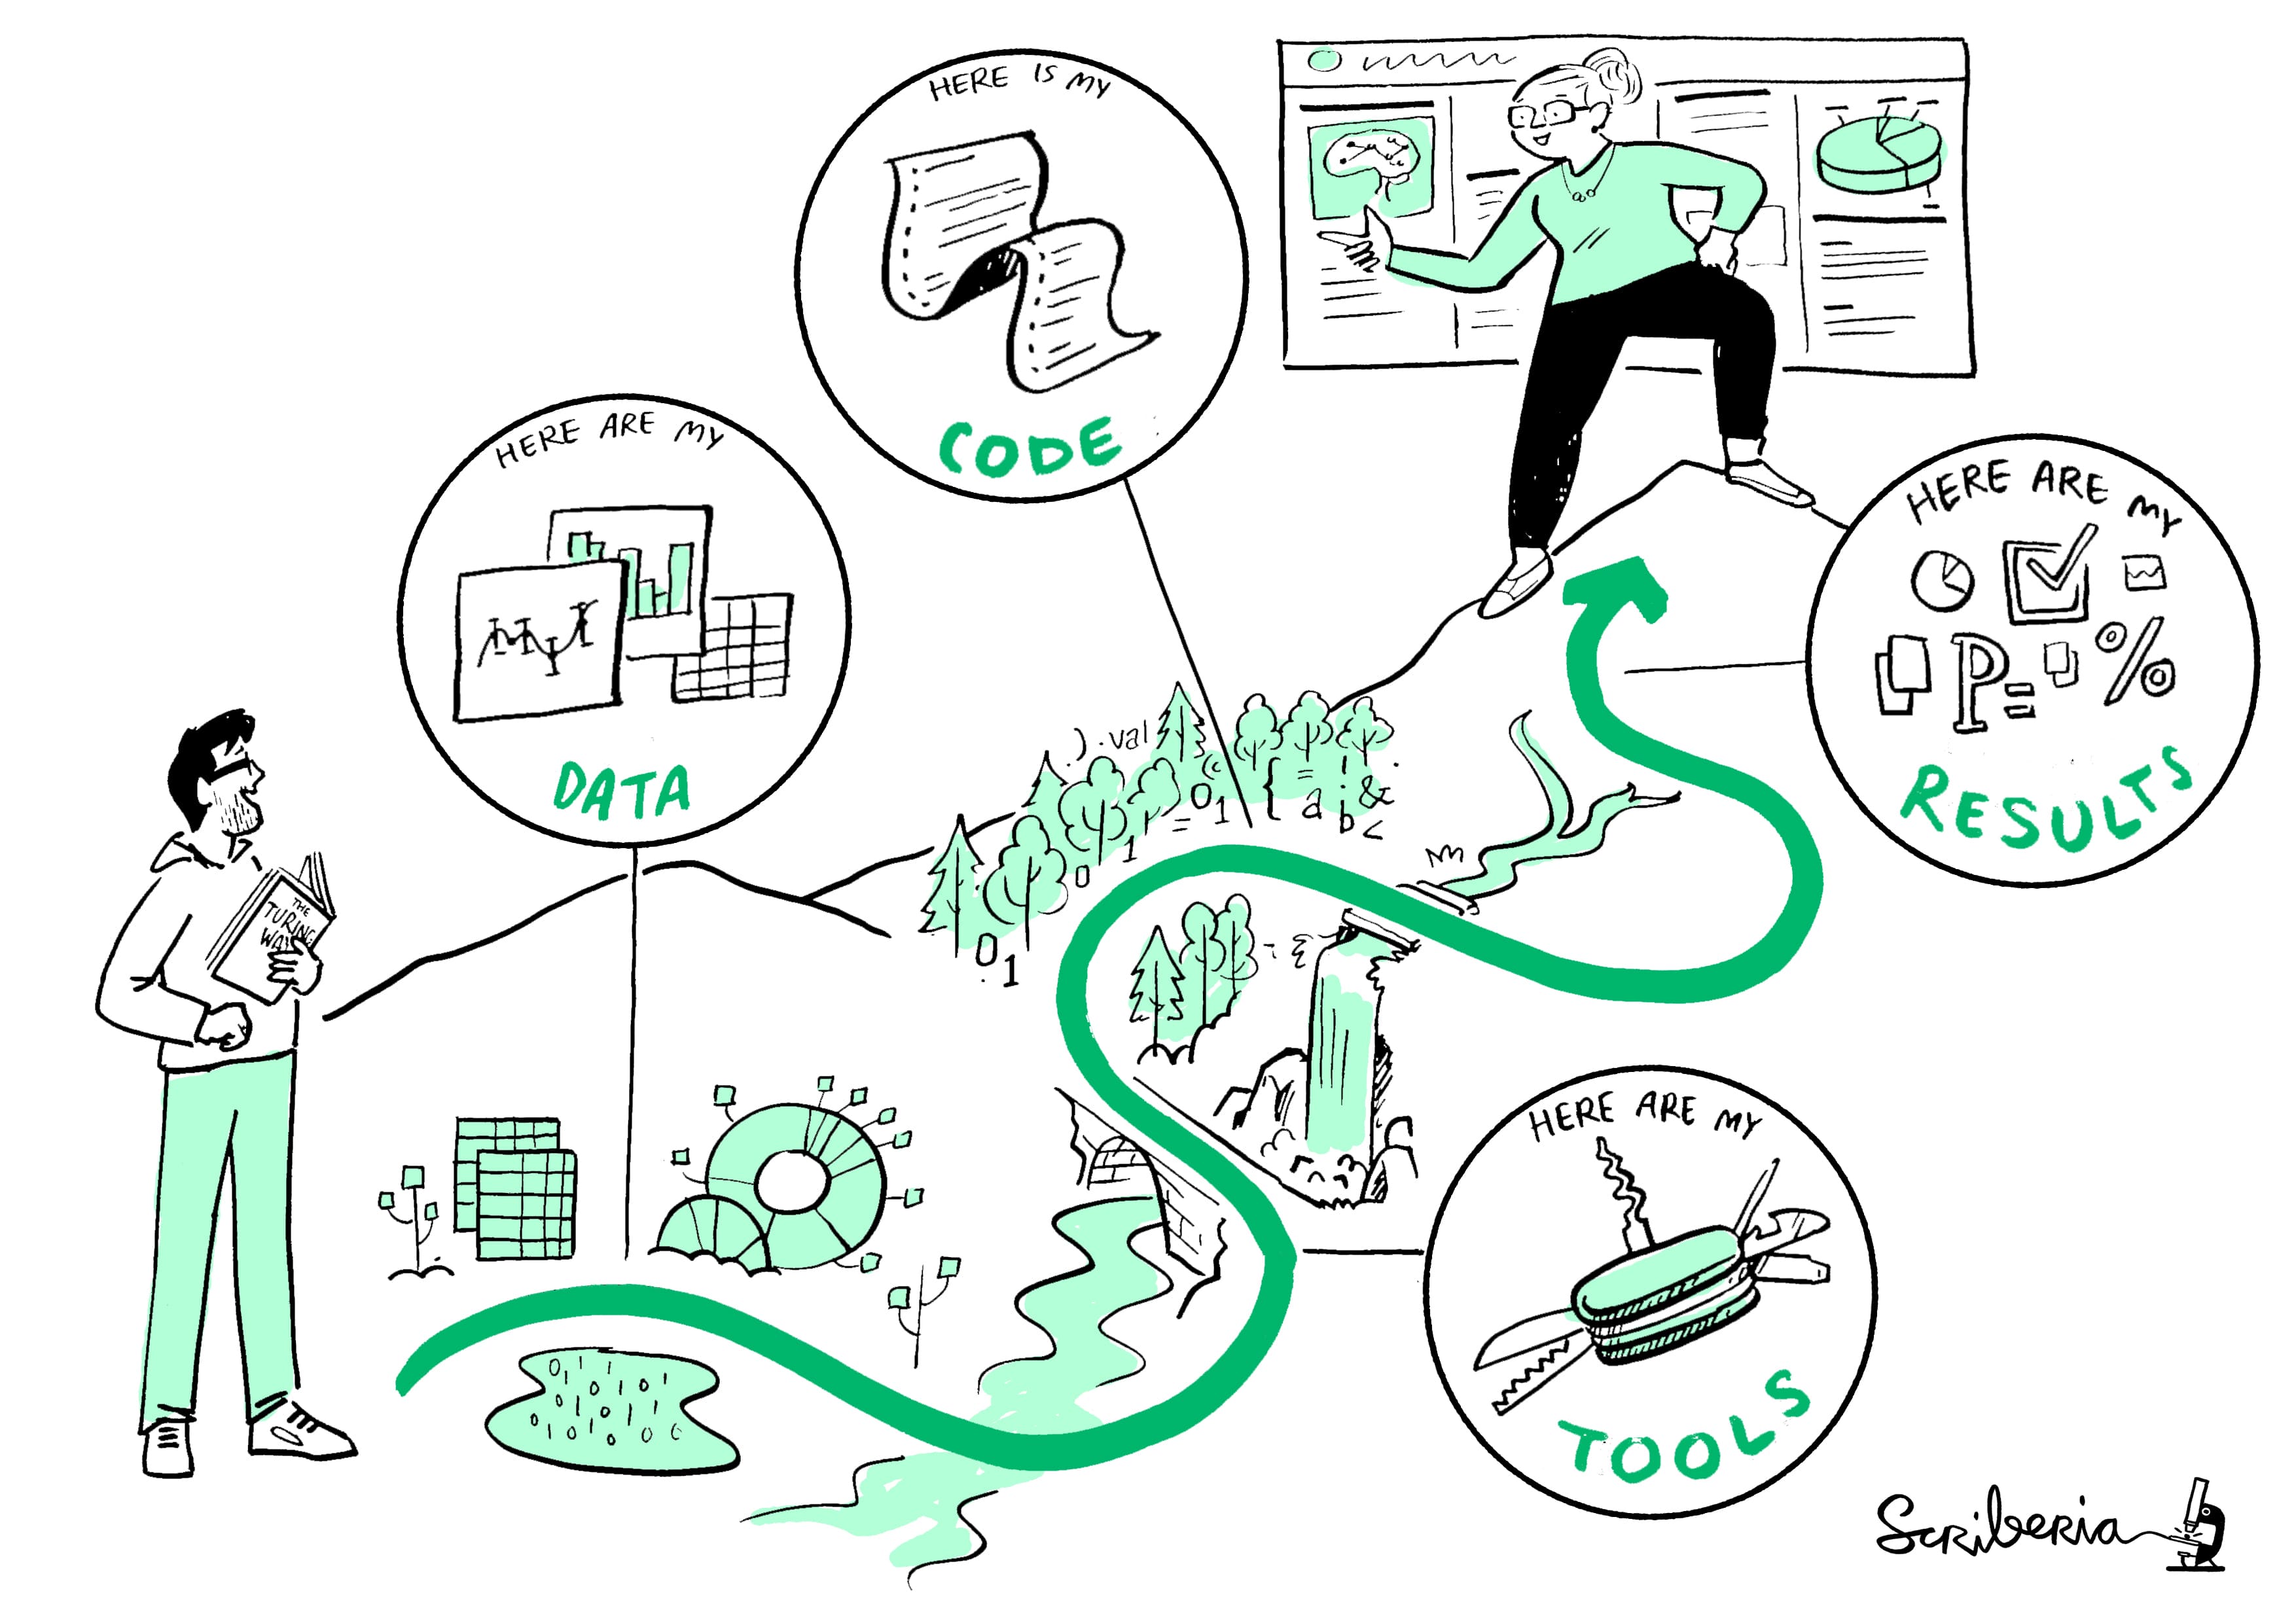
Fuente: The Turing Way project & Scriberia. http://doi.org/10.5281/zenodo.3332807
¿A cuáles herramientas nos referimos?
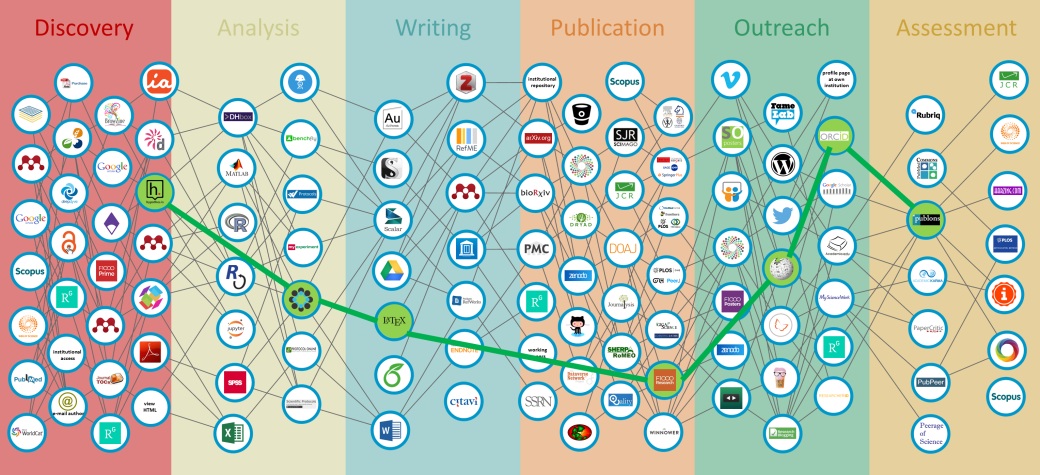
Fuente: Joint Roadmap for Open Science Tools https://jrost.org/2018/09/13/workshop.html
Independientemente de si tengo o no interés en publicar, ¿por qué me debería importar esto?
Cosas que pasan en trabajos
Hola Marcela,
Muchas gracias por el reporte, las 40 páginas de resultados están muy interesantes.
Hay un pequeño detalle: hablé con el asistente y me dijo que había un error en la lectura del espectrofotómetro. Los registros del 86900 al 95000 no deben tomarse en cuenta para el análisis. ¿Podés rehacer el reporte con esa corrección?
Cosas que pasan en trabajos
Hola Carlos,
¡Bienvenido a nuestra oficina!
Tu trabajo durante el primer semestre será hacer los reportes de consumo de electricidad de las áreas residenciales del cantón.
Los datos actualizados se pueden accesar en este servidor XX cada lunes, y necesitamos un reporte escrito para la jefa que sea consistente a través del tiempo.
Cosas que pasan en trabajos
Estimada autora,
Le adjuntamos las correcciones de su artículo.
Le rogamos conteste los comentarios de las personas revisoras en un documento a parte y entregue la versión corregida del artículo específicando exactamente qué cambió y dónde.
En resumen:
Como seres humanos, siempre podemos equivocarnos.
Muchas labores de la academia, industria, gobierno, son repetitivas, y pueden automatizarse. Eso si, siempre asegurando un control de calidad.
La transparencia y trazabilidad en nuestro trabajo puede ayudar a comunicarnos mejor con nuestros colaboradores, pero sobre todo con nosotros mismos en el futuro.
Ventajas de la investigación reproducible
Seguimiento de un historial completo de su investigación
La investigación reproducible debe contener una historia completa y narrativa o procedencia del proceso de planificación y desarrollo del proyecto.
Al almacenar un historial completo de nuestro trabajo, podemos garantizar la sostenibilidad de la investigación, y la utilidad de nuestro trabajo y el de los demás en nuestros campos de investigación.
Fuente: https://the-turing-way.netlify.app/reproducible-research/overview/overview-benefit.html#rr-overview-benefits
Ventajas de la investigación reproducible
Facilita el proceso de colaboración y revisión
Al diseñar flujos de trabajo reproducibles y compartirlos con los diferentes componentes de nuestro proyecto de investigación, podemos permitir que otros desarrollen una comprensión profunda de nuestro trabajo.
Esto los anima a revisar nuestros métodos, probar nuestro código, proponer cambios útiles y hacer contribuciones bien pensadas para seguir desarrollando nuestro proyecto.
Los flujos de trabajo reproducibles facilitan enormemente el proceso de revisión por pares al permitir que los revisores accedan a las diferentes partes de los proyectos que son necesarias para validar los resultados de la investigación.
Fuente: https://the-turing-way.netlify.app/reproducible-research/overview/overview-benefit.html#rr-overview-benefits
Ventajas de la investigación reproducible
Publicación de investigaciones validadas que evitan la información errónea
La falta de reproducibilidad es uno de los principales factores que conducen a la retracción del papel (ver Retraction Watch).
Al trabajar de manera reproducible, podemos desarrollar un trabajo de investigación validado, evitar la información errónea que puede limitar la replicabilidad de nuestro trabajo y publicar resultados de investigación precisos. Este aspecto no solo respalda la validez del trabajo actual, sino cualquier estudio futuro que se base en investigaciones reproducibles.
Fuente: https://the-turing-way.netlify.app/reproducible-research/overview/overview-benefit.html#rr-overview-benefits
Ventajas de la investigación reproducible
Escritura de trabajos, tesis e informes de manera eficiente
Los análisis bien documentados nos ayudan a mantener un fácil acceso a todos los resultados generados dentro de un proyecto que se pueden redactar de manera eficiente.
Si trabaja en equipo, los colaboradores pueden obtener fácilmente el reconocimiento en términos de autoría por sus contribuciones. Además, al hacer uso del conjunto de datos y los métodos subyacentes, podemos cumplir fácilmente con las pautas de revistas de más alto nivel.
Fuente: https://the-turing-way.netlify.app/reproducible-research/overview/overview-benefit.html#rr-overview-benefits
Ventajas de la investigación reproducible
Obtención de crédito por su trabajo, de manera justa
- La aplicación de prácticas de reproducibilidad por separado en diferentes partes del proyecto, como datos, códigos y scripts ejecutables de forma independiente, protocolos e informes, permite a otros investigadores probar y reutilizar nuestro trabajo en su investigación y brinda un reconocimiento justo a nuestro trabajo.
Fuente: https://the-turing-way.netlify.app/reproducible-research/overview/overview-benefit.html#rr-overview-benefits
Ventajas de la investigación reproducible
Asegure la continuidad de su trabajo
Al seguir las pautas de reproducibilidad, podemos comunicar fácilmente nuestro trabajo con diferentes partes interesadas, como nuestros supervisores, patrocinadores, revisores, estudiantes y posibles colaboradores.
Esto asegura la continuidad de una idea de investigación e incluso puede encontrar nuevas aplicaciones en otros contextos. El progreso de tales proyectos puede ser fácilmente monitoreado y continuado, ya sea por otros investigadores o por usted mismo, si desea desarrollar su propio trabajo después de un período más largo.
Fuente: https://the-turing-way.netlify.app/reproducible-research/overview/overview-benefit.html#rr-overview-benefits
¿Cómo hago para empezar?
- Organice sus datos y código.
- Todo con un script (sobre todo el pre-procesamiento de los datos).
- Automatice procesos.
- Convierta los scripts en informes reproducibles (utilizando RMarkdown o Quarto, por ejemplo).
- Convierta el código repetido en funciones.
- Convierta las funciones repetidas en paquetes.
- Use control de versiones.
- Licencie su software.
Fuente: Initial Steps toward Reproducible Research. https://kbroman.org/steps2rr/
Consejos importantes
Siempre guarde los datos originales por separado y con permisos de solo lectura.
Evite usar paths absolutos en su código.
Use nombres de archivos que se expliquen por sí solos. No use “final” en sus archivos.
Siempre escriba un archivo Readme.
Guarde la semilla (seed) antes de usar cualquier procedimiento aleatorio.
Evite a toda costa editar “a mano” (o en cualquier software de point and click) los archivos de datos.
Fuente: Initial Steps toward Reproducible Research. https://kbroman.org/steps2rr/
¿Cuál es el problema con Excel?
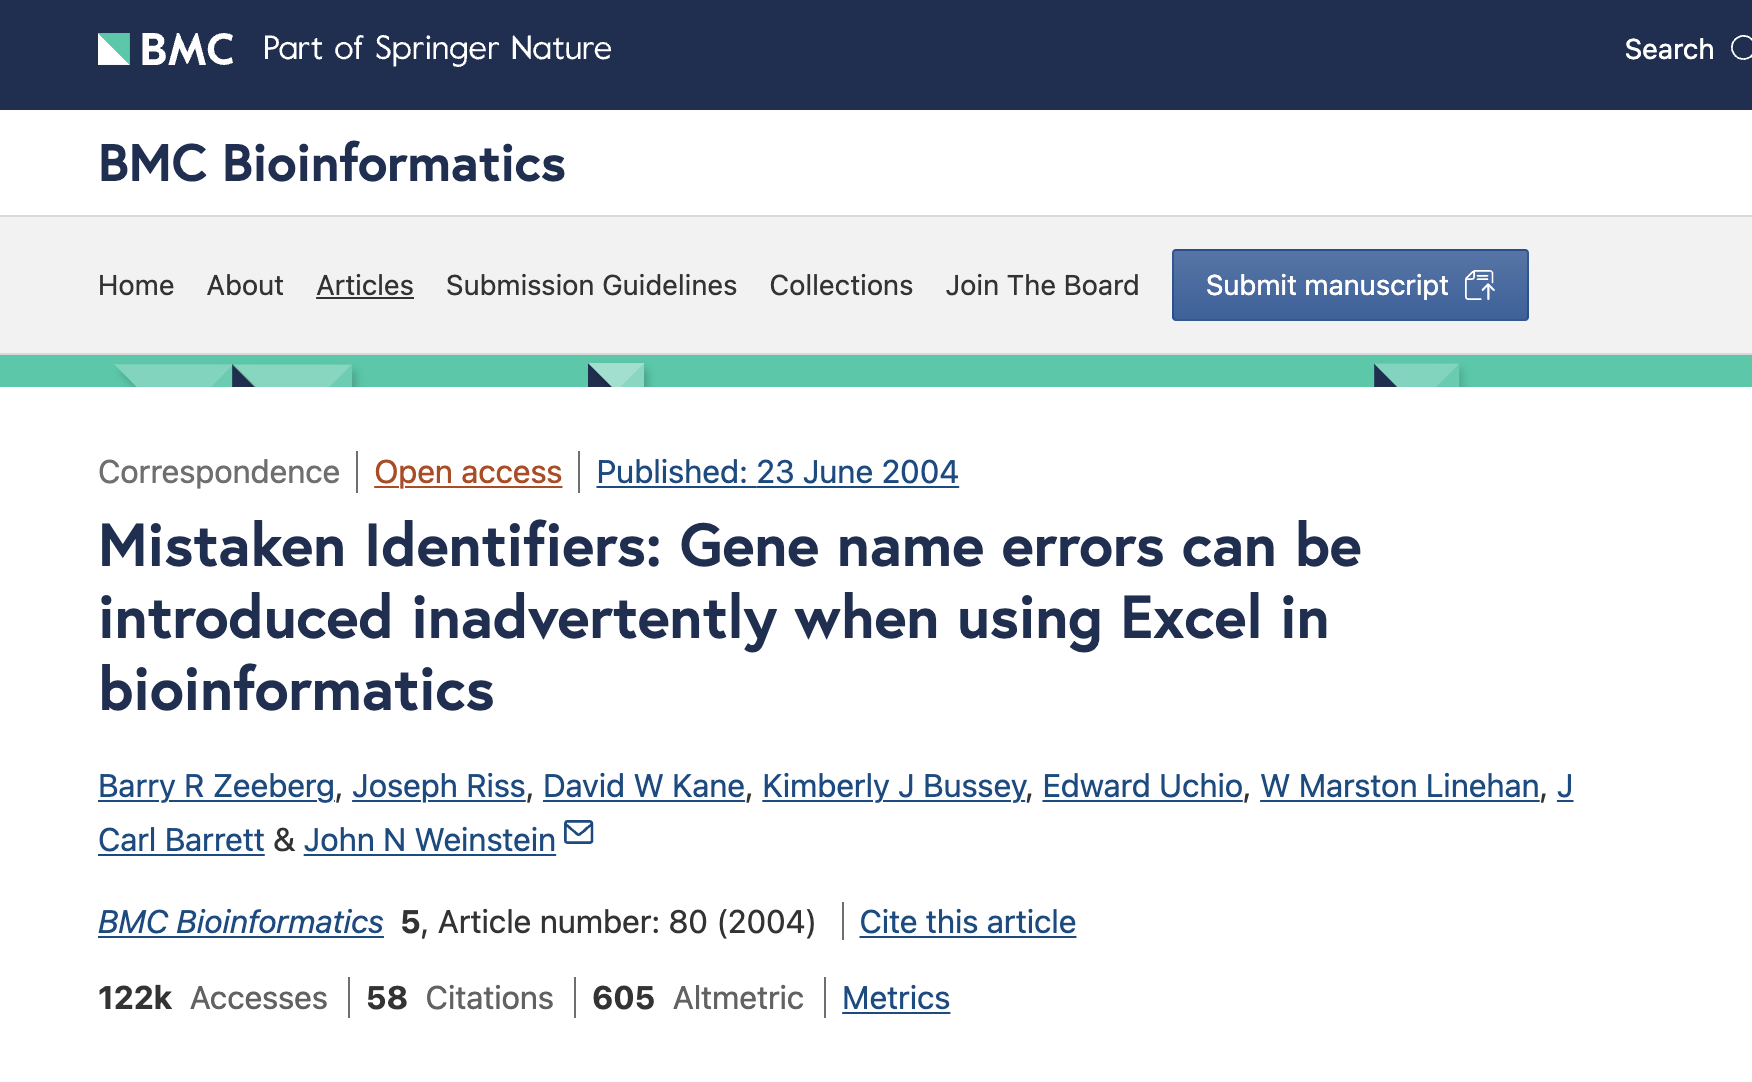
Fuente: Scary Excel Stories. https://github.com/jennybc/scary-excel-stories
Control de versiones
Puede usarlo en distintas plataformas (Git: Gitlab, Github, Bitbucket; Mercurial; etc.)
Puede facilitar la exploración del historial de cambios
Le permite volver a un estado anterior para encontrar la fuente de un error
Le permite probar cosas sin preocuparse por romper las cosas que funcionan
Puede facilitar la incorporación de cambios de los colaboradores, incluso si todos realizan cambios simultáneos en el mismo conjunto de archivos
Excelente herramienta de colaboración
Empiece por aquí: https://happygitwithr.com/
¿Qué falta para ser reproducible y sostenible?
- Planes de Manejo de Datos
- Ambientes Reproducibles (¿con cuál versión corre mi código?)
- BinderHub - ¿puedo crear un espejo de mi ambiente para correr mi análisis?
- Control de calidad del código
- Code Testing
- Revisión de código por pares
- Uso de compendios ejecutables
- Créditos por partes del trabajo + Identificadores únicos
- Evaluación de riesgos
Fuente: Guía para la investigación Reproducible. The Turing Way. https://the-turing-way.netlify.app/reproducible-research/reproducible-research.html
Una tarea para Uds:
Individualmente, piense en su último proyecto que involucró un análisis de datos. Pregúntese:
¿Puede volver a correr el mismo análisis en su computadora?
¿Es posible que otra persona reproduzca su análisis (desde la lectura de datos hasta la producción del reporte completo) en otra computadora distinta? ¿tiene instrucciones suficientes? ¿puede facilmente juntar todo lo que se necesita en un solo archivo?
¿Cuáles pasos puede adoptar para mejorar la reproducibilidad de sus análisis de datos desde ya?
Ahora comente con la persona a su lado acerca de su experiencia. En 5 minutos compartiremos las experiencias con todo el grupo.
¿Qué es Quarto?
Intro
¿Qué es un análisis de datos reproducible?
¿Qué es Quarto?
Empecemos con Quarto
Crear un reporte en Quarto
Iterando sus reportes
Dele estilo a sus reportes
Usar otros formatos
Usar co-pilot en R
¡Muchas gracias!
¿Qué es Quarto?
Quarto® es una herramienta
de código abierto
cientifica y técnica
también es un sistema de publicación
construido en Pandoc.
¿Qué es Quarto?
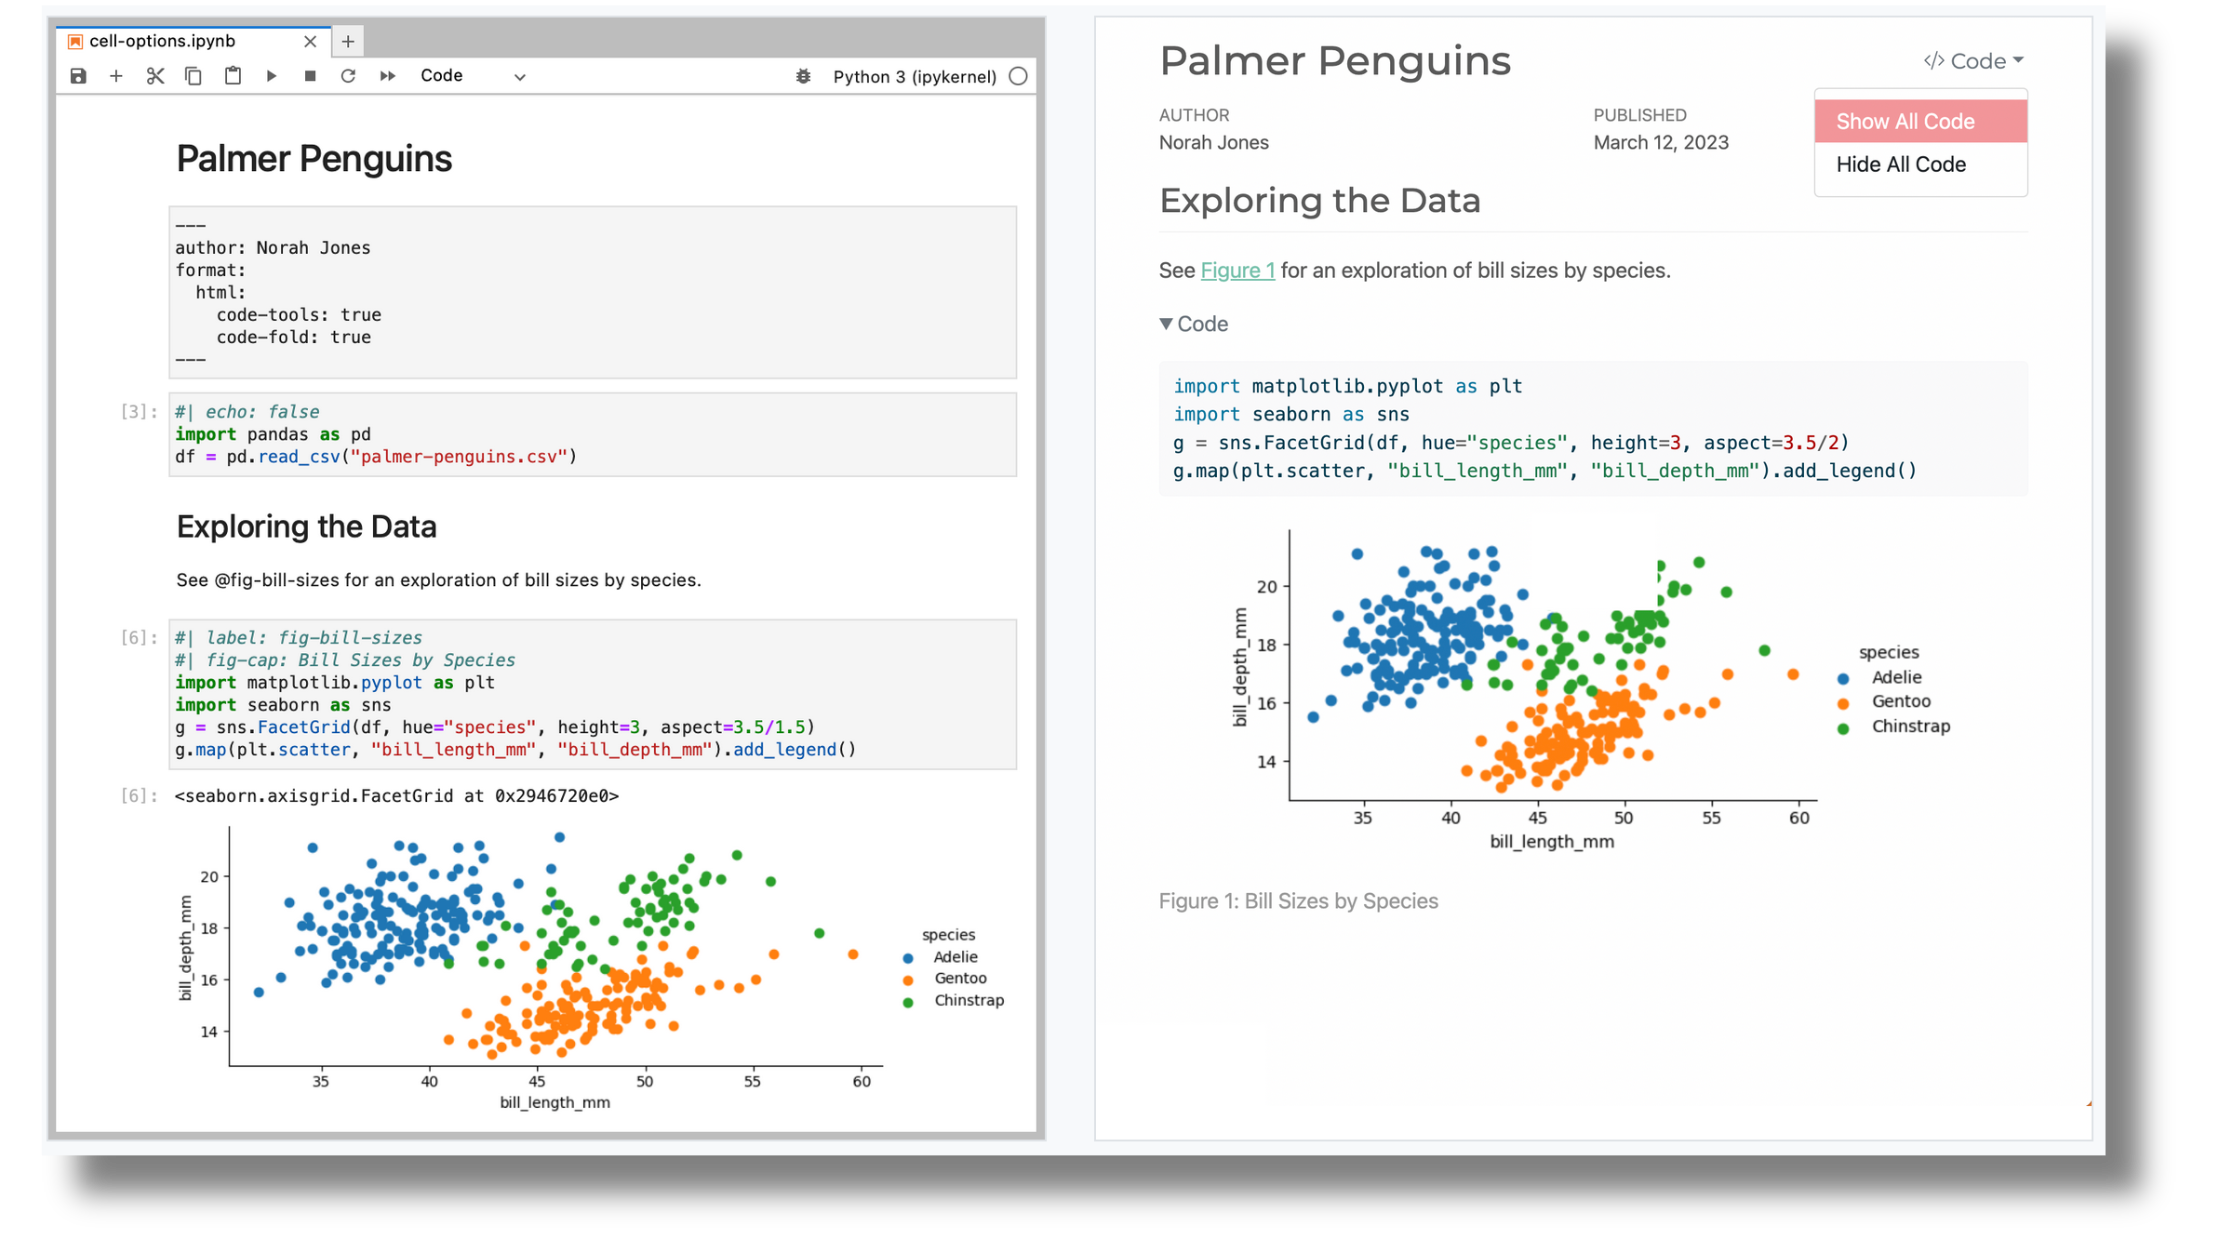
Origen de Quarto
- Proyecto Open Source financiado por Posit (antes RStudio)
- El equipo tiene 10 años de experiencia con knitr/R Markdown
- Sin embargo, la necesidad de integrar R con otros lenguajes de programación se ha vuelto más común y necesaria…
La pregunta que dió a su creación fue: ¿podemos reimplementar R Markdown de una manera que no sea únicamente con R?
Metas de Quarto
- Crear documentos computacionales que puedan incluir código fuente para automatización y reproducibilidad.
- Reducir la dificultad de crear un documento científico.
- Activar y hacer disponible un “single-source publishing” — es decir, una herramienta que pueda crear Word, PDFs, HTML, etc. desde una sola fuente.
Quarto formats
Quarto puede crear varios tipos de documentos, incluyendo:
- Websites
- Libros
- Blogs
- Presentaciones
- y por supuesto, reportes!
¿Por qué Quarto?
- Automatización: Actualice su reporte o código.
- Reproducibilidad: Documente su proceso y facilite la reproducibilidad y la replicabilidad de su trabajo.
- Flexibilidad: Agregue varias fuentes de datos, cree figuras, tablas, diagramas, etc.
- Sistema de publicación single-source: Puede crear versiones HTML, PDF, Word desde una sola fuente.
¿Y por qué Quarto y no R Markdown?
Ultimadamente, es su decisión!
- R Markdown continuará siendo mantenido, pero Quarto recibirá prioridad en número y calidad de actualizaciones.
- Si Ud usa Python o Julia, puede usar la misma herramienta para combinar código, o para usarlos sin dependender de R.
- Quarto proporciona un ecosistema unificado con expresión compartida para las características principales.
- Quarto también tiene extensiones para personalizar tus documentos.
Empecemos con Quarto
Intro
¿Qué es un análisis de datos reproducible?
¿Qué es Quarto?
Empecemos con Quarto
Crear un reporte en Quarto
Iterando sus reportes
Dele estilo a sus reportes
Usar otros formatos
Usar co-pilot en R
¡Muchas gracias!
Utilizaremos RStudio
Ud puede usar Quarto en RStudio, VS Code, Jupyter, Neovim, y otros editores de texto.
Para este taller, vamos a usar RStudio, que viene con Quarto incluido en sus últimas versiones.
Crear un documento en Quarto
Podemos crear un nuevo documento de Quarto en File > New File > Quarto Document.
- Note la extensión
.qmden el documento de Quarto.
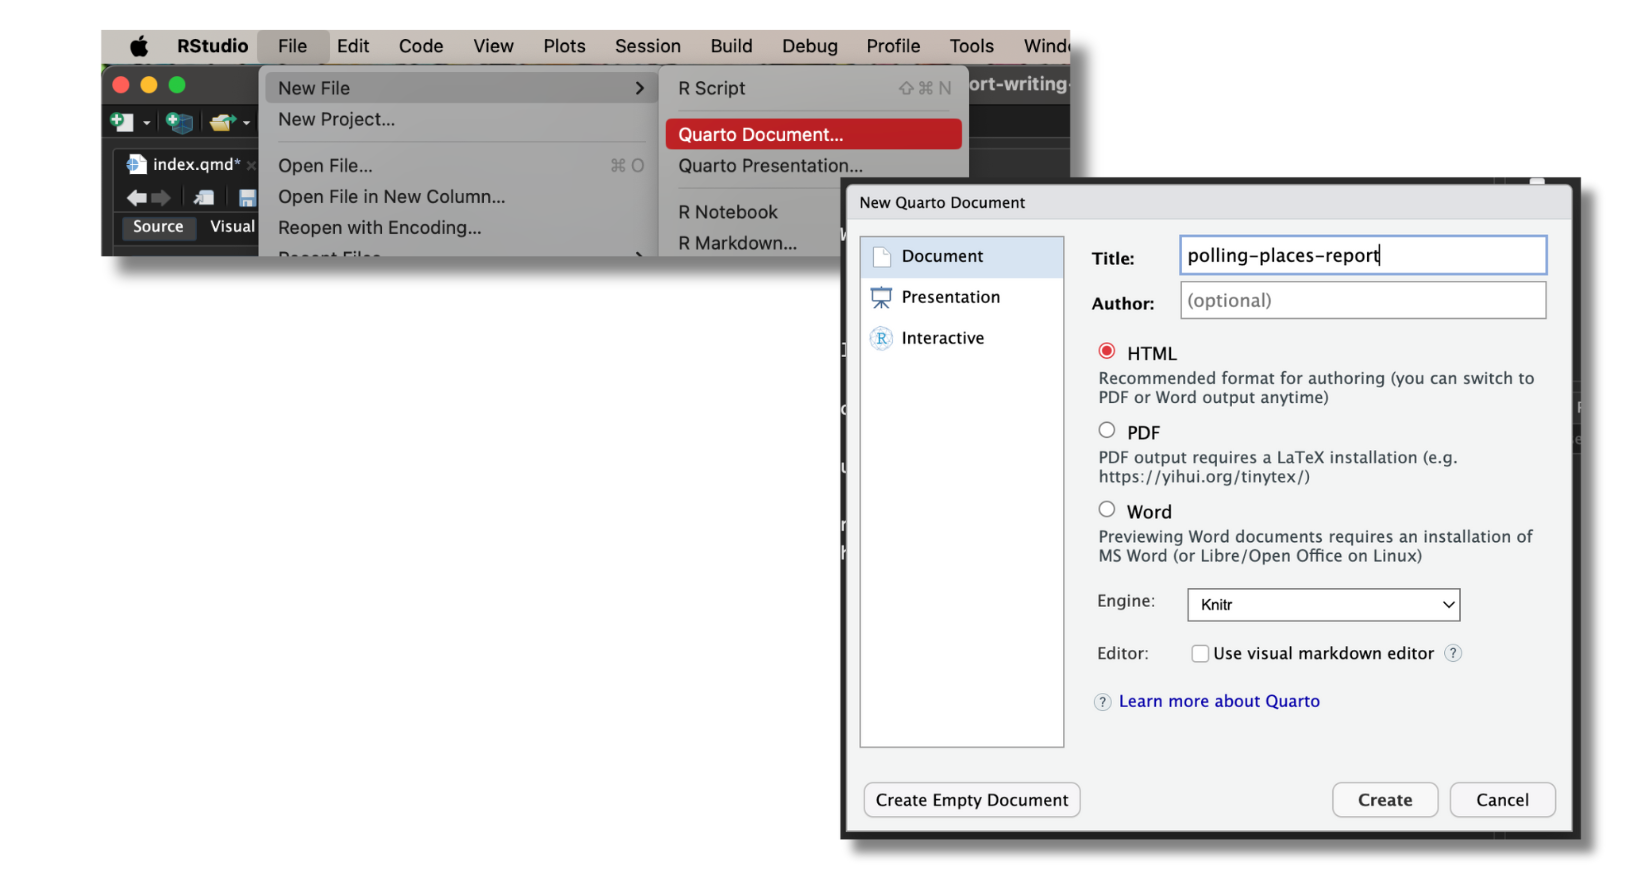
Crear un documento en Quarto
Así luce un documento de Quarto default
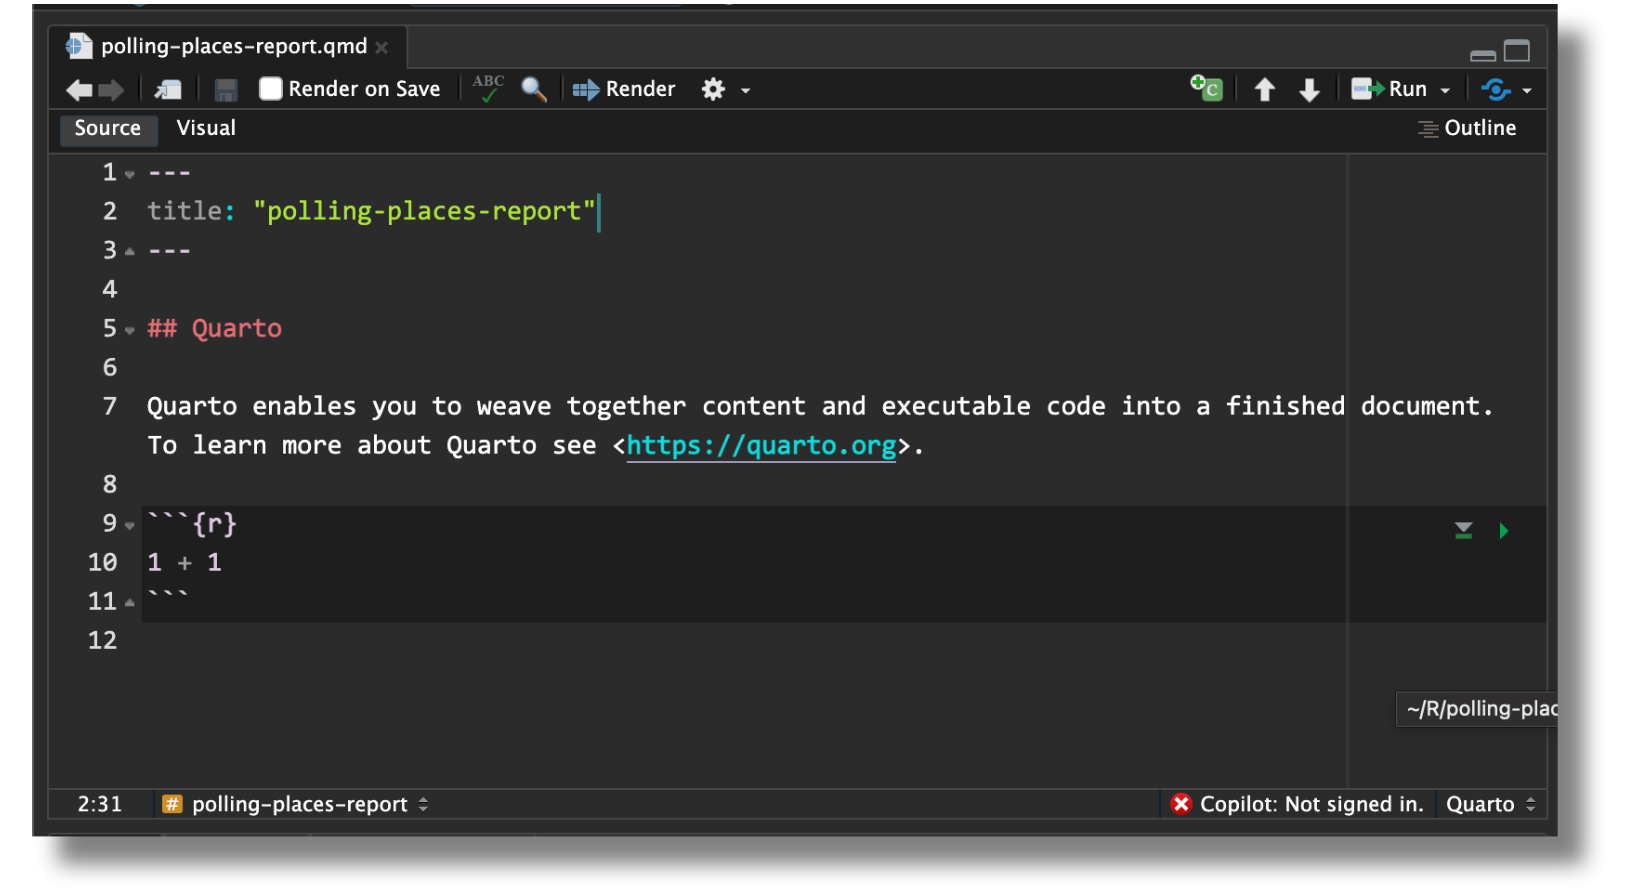
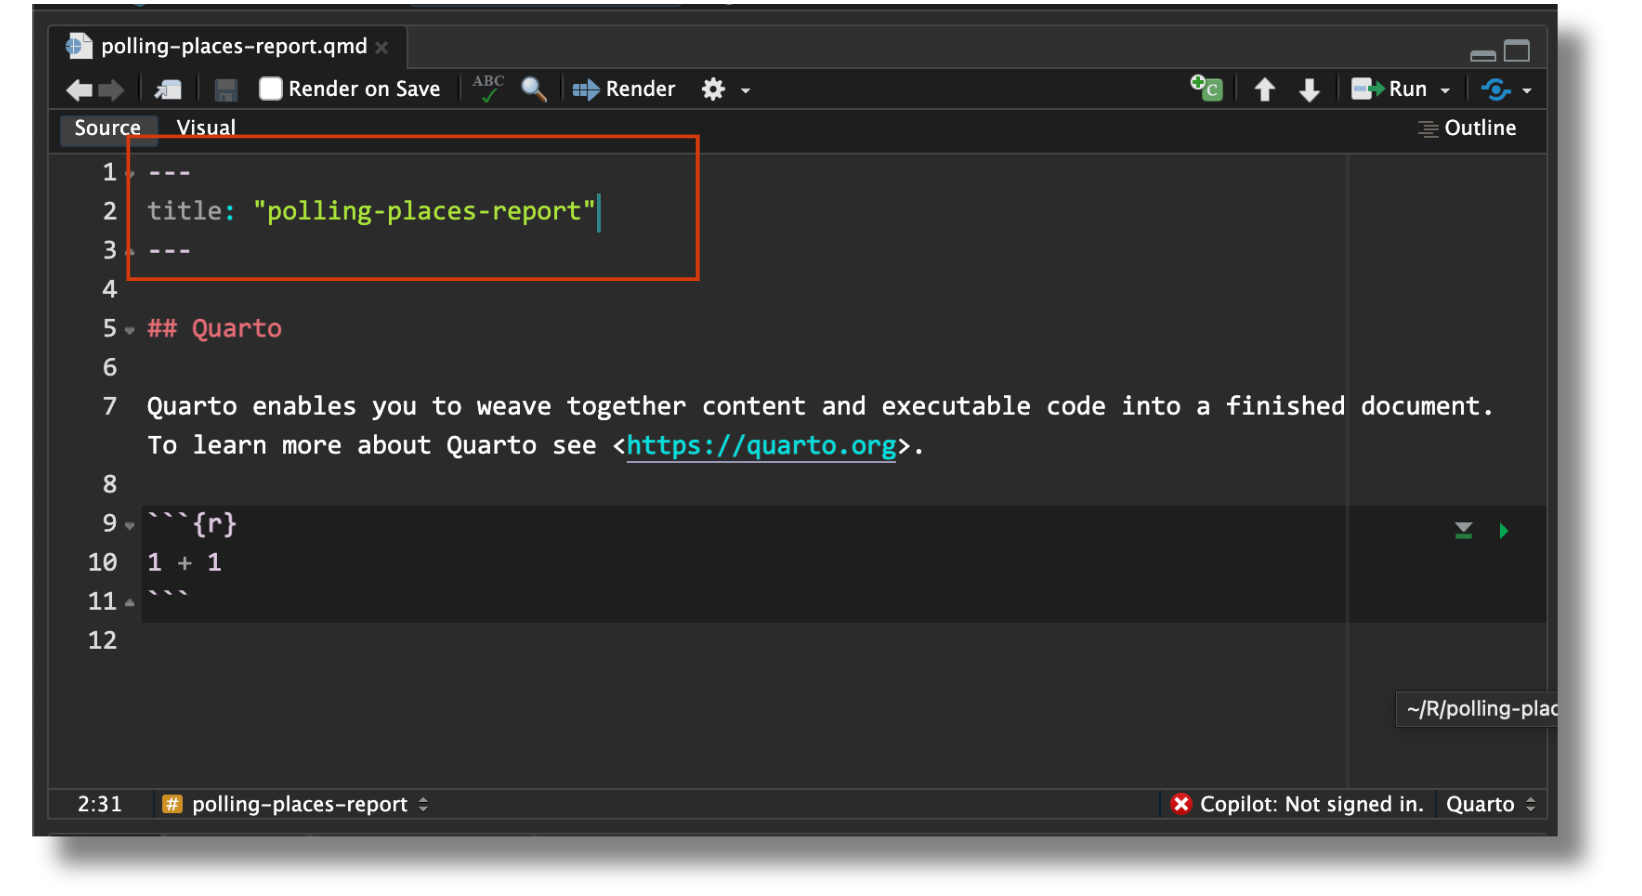
YAML header
- Estos son los metadatos de su documento
- Está demarcado por tres guiones (—) al inicio y al final.
- Utiliza el formato de pares key-value:
key: value
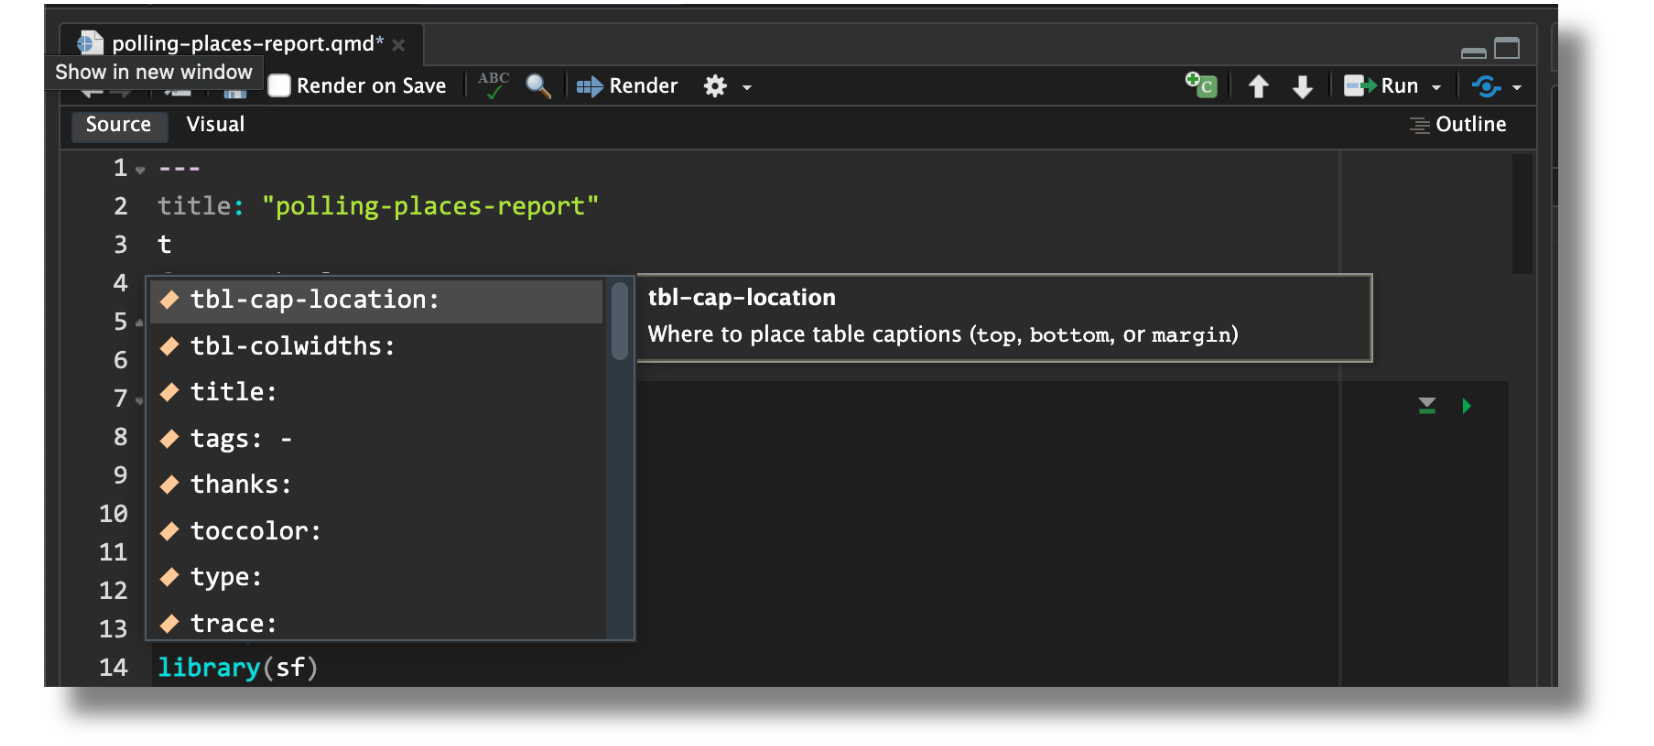
YAML autocompleta
- YAML inteligente está disponible
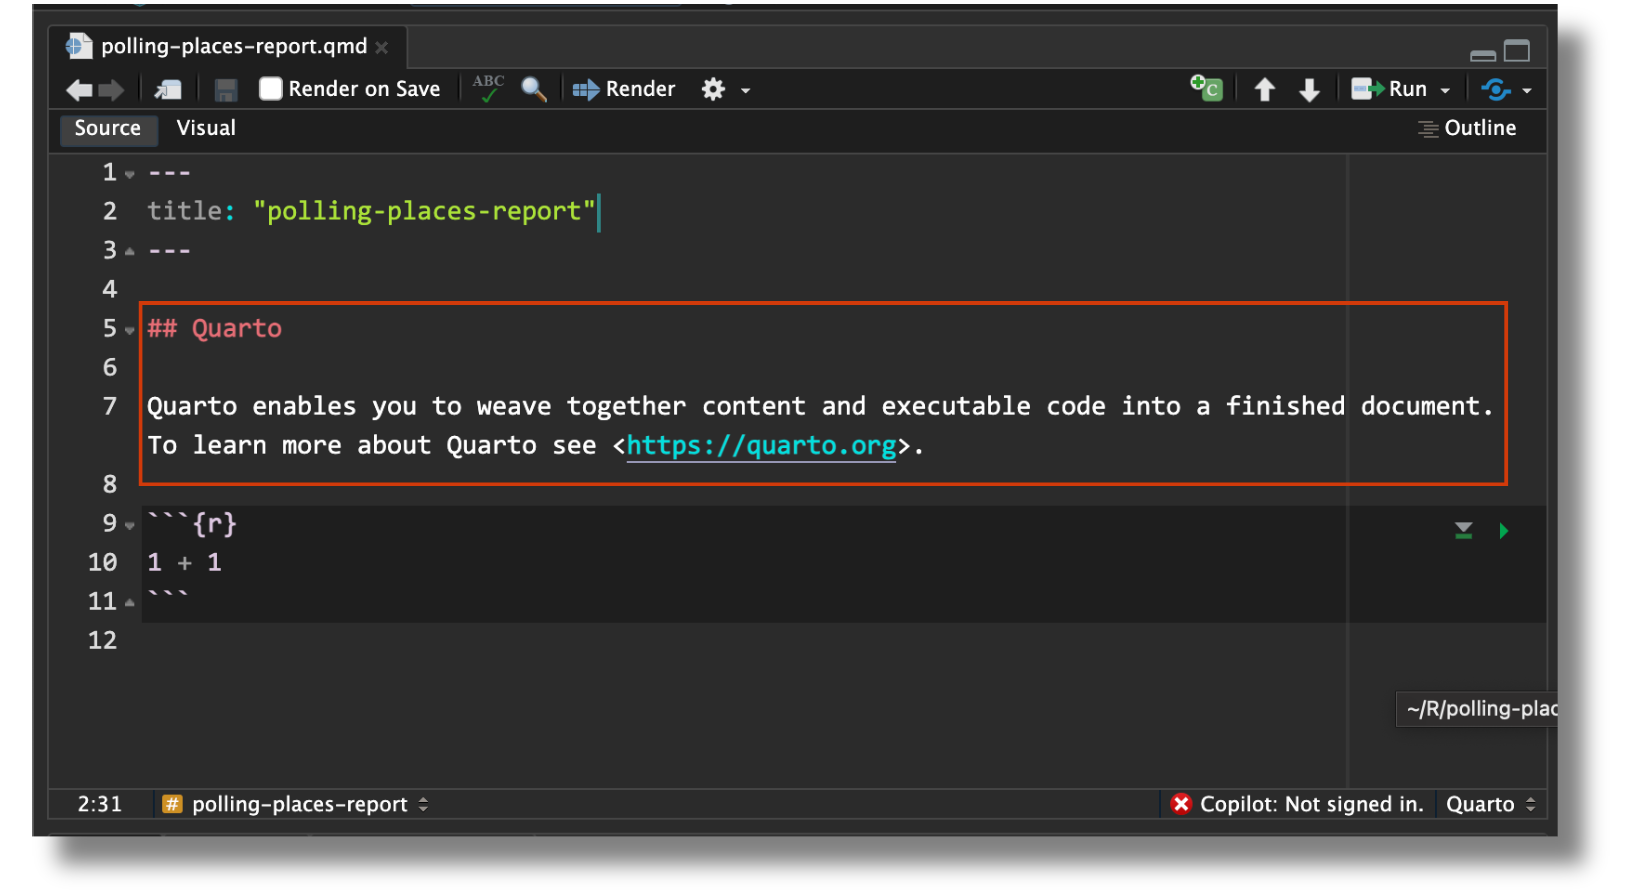
Texto en Markdown
- Markdown es un lenguaje ligero para crear texto con formato.
- Quarto se basa en Pandoc y utiliza su variación de Markdown como sintaxis de documento subyacente.
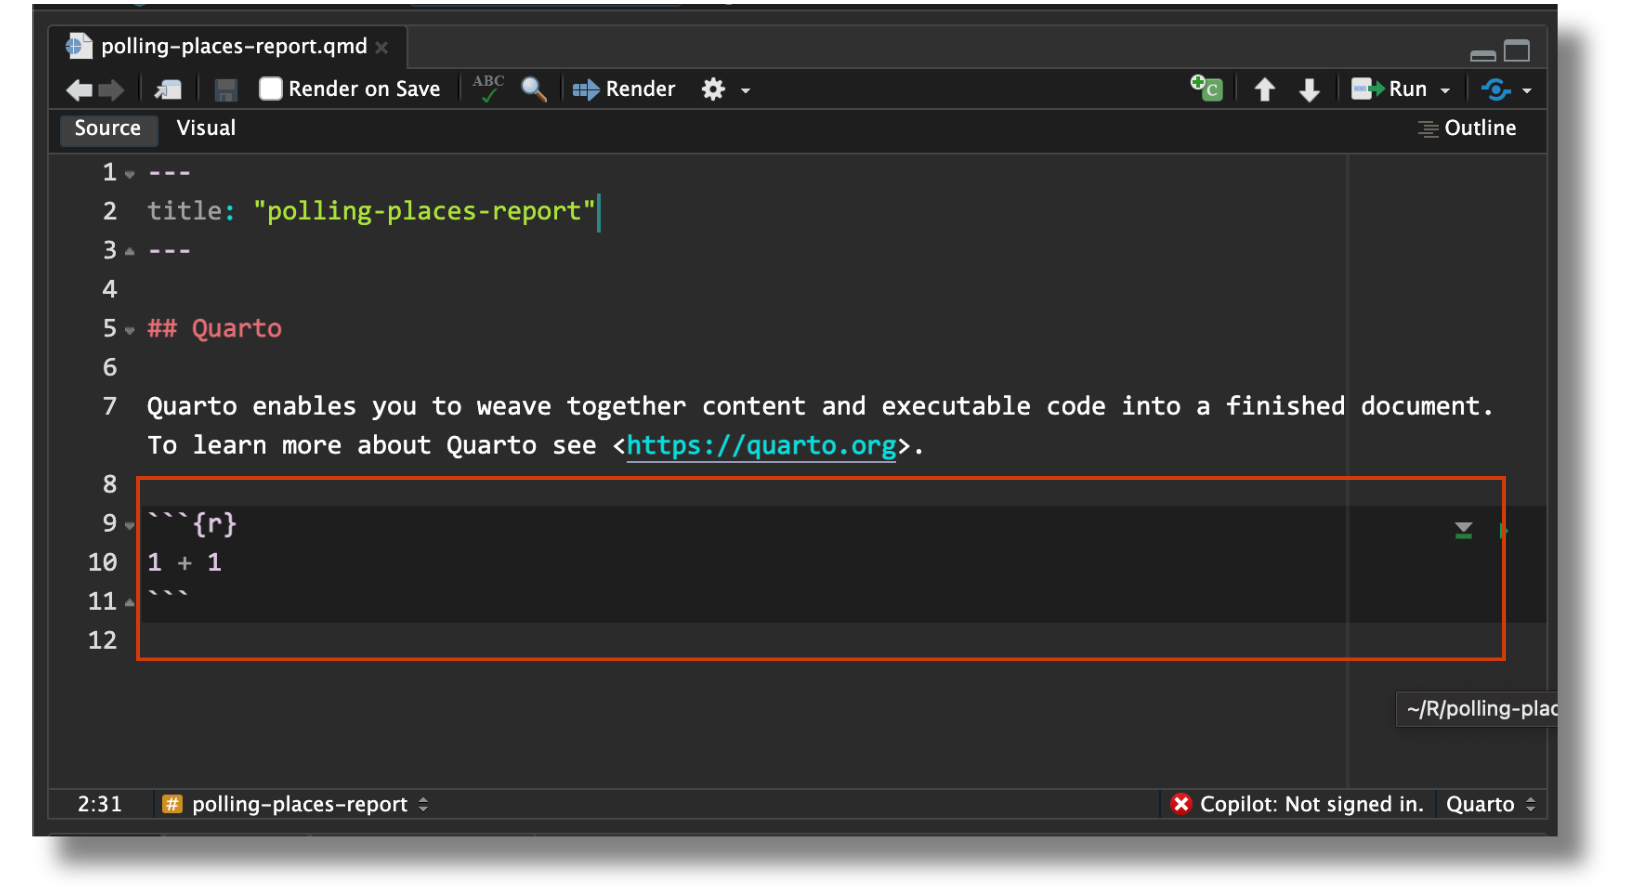
Código ejecutable
- Los fragmentos de código comienzan y terminan con tres comillas invertidas (normalmente)
- Los fragmentos de código se identifican con un lenguaje de programación entre
{} - Puede incluir opciones de fragmentos opcionales, en estilo YAML, identificadas por
#|al principio de la línea
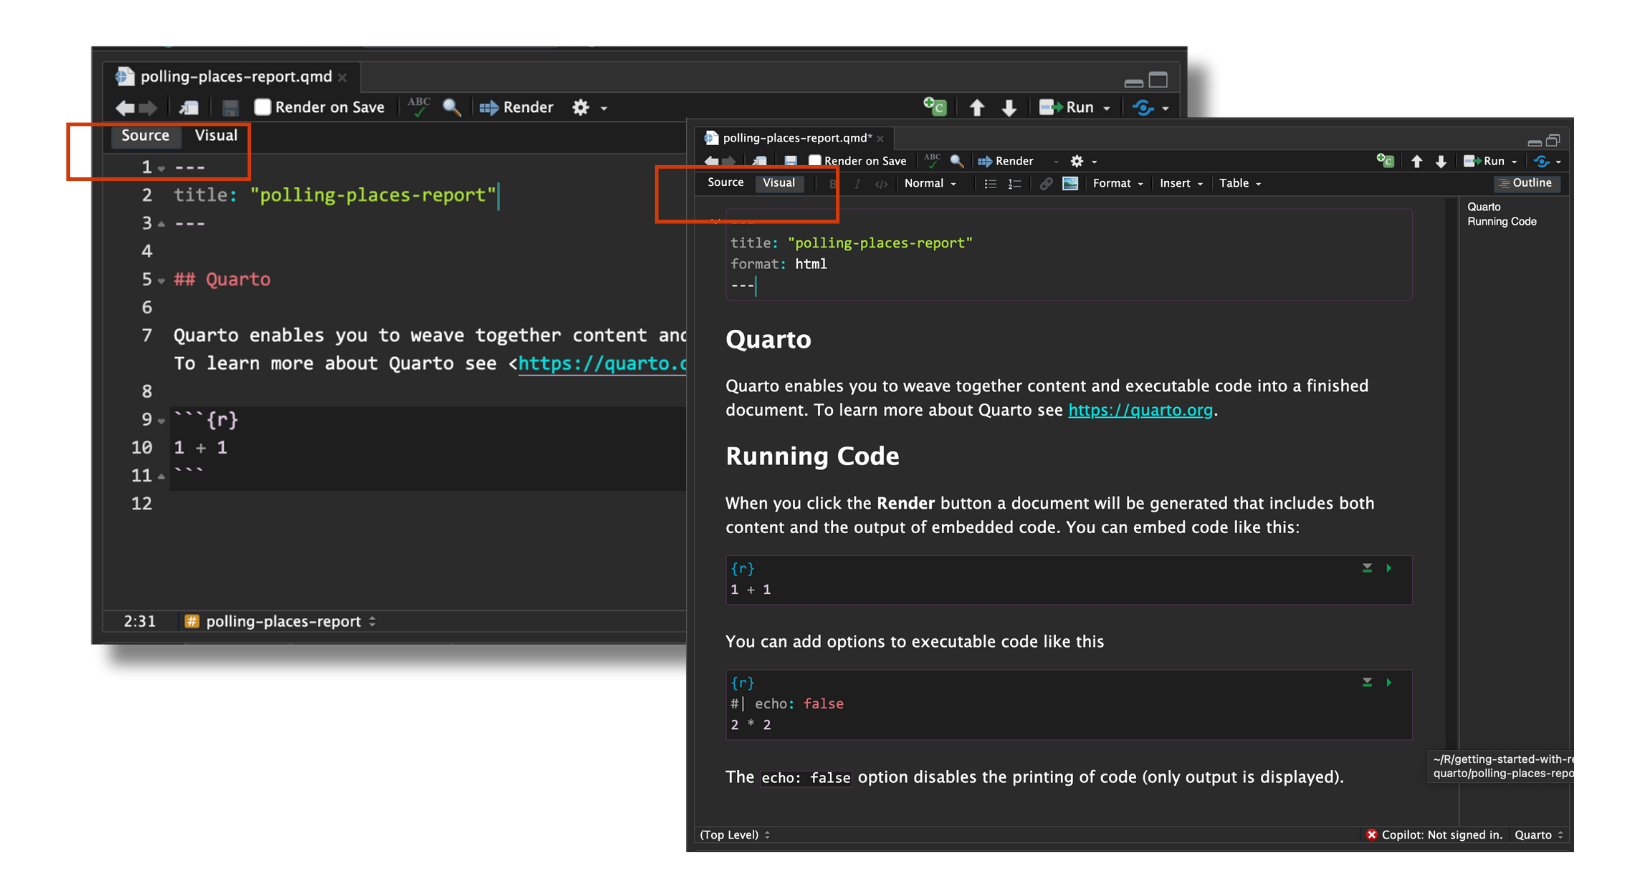
Dos editores en R Studio: código fuente y visual
- RStudio incluye un editor visual para Quarto Markdown, que incluye soporte para tablas, citas, referencias cruzadas, notas a pie de página y más:
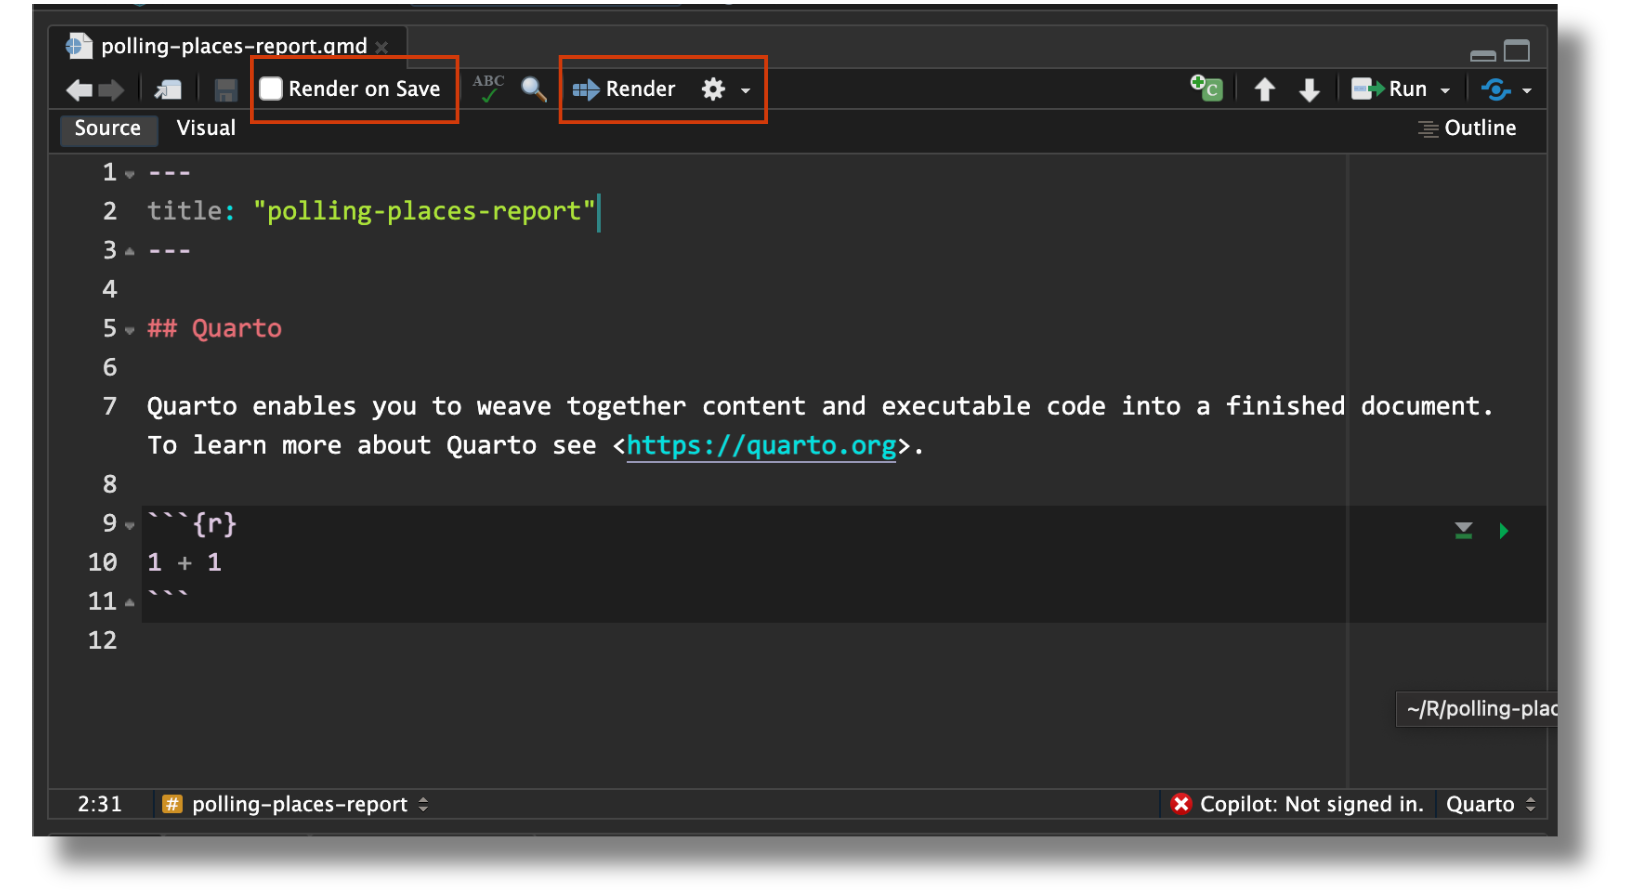
Creando un nuevo documento en Quarto
Utilice el botón Render para obtener una vista previa de los documentos a medida que los edita.
- Marque Render on Save para renderizar automáticamente cada vez que guarde
Vamos a RStudio!
Crear un reporte en Quarto
Intro
¿Qué es un análisis de datos reproducible?
¿Qué es Quarto?
Empecemos con Quarto
Crear un reporte en Quarto
Iterando sus reportes
Dele estilo a sus reportes
Usar otros formatos
Usar co-pilot en R
¡Muchas gracias!
Edite el encabezado YAML
- Incluya metadatos como autor, subtítulo, fecha y opciones de personalización como tema, color de fuente, ancho de figura, etc.
- Aquí editamos el título, autor y fecha de publicación.
embed-resources: truees muy importante para crear archivos HTML independientes- Podemos agregar opciones de fragmentos globales con
ejecutar
Agregue un chunk para requerimientos
- Podemos agregar opciones de fragmentos por bloque de código usando
#| - En este fragmento de configuración, cargue todos los paquetes y el conjunto de datos.
Cree un primer borrador
A continuación, podemos crear un borrador del informe agregando:
- Texto y formato de texto.
- Encabezados
- Listas
- Cifras
- Mesas
- Columnas
- Referencias cruzadas
- Subtítulos
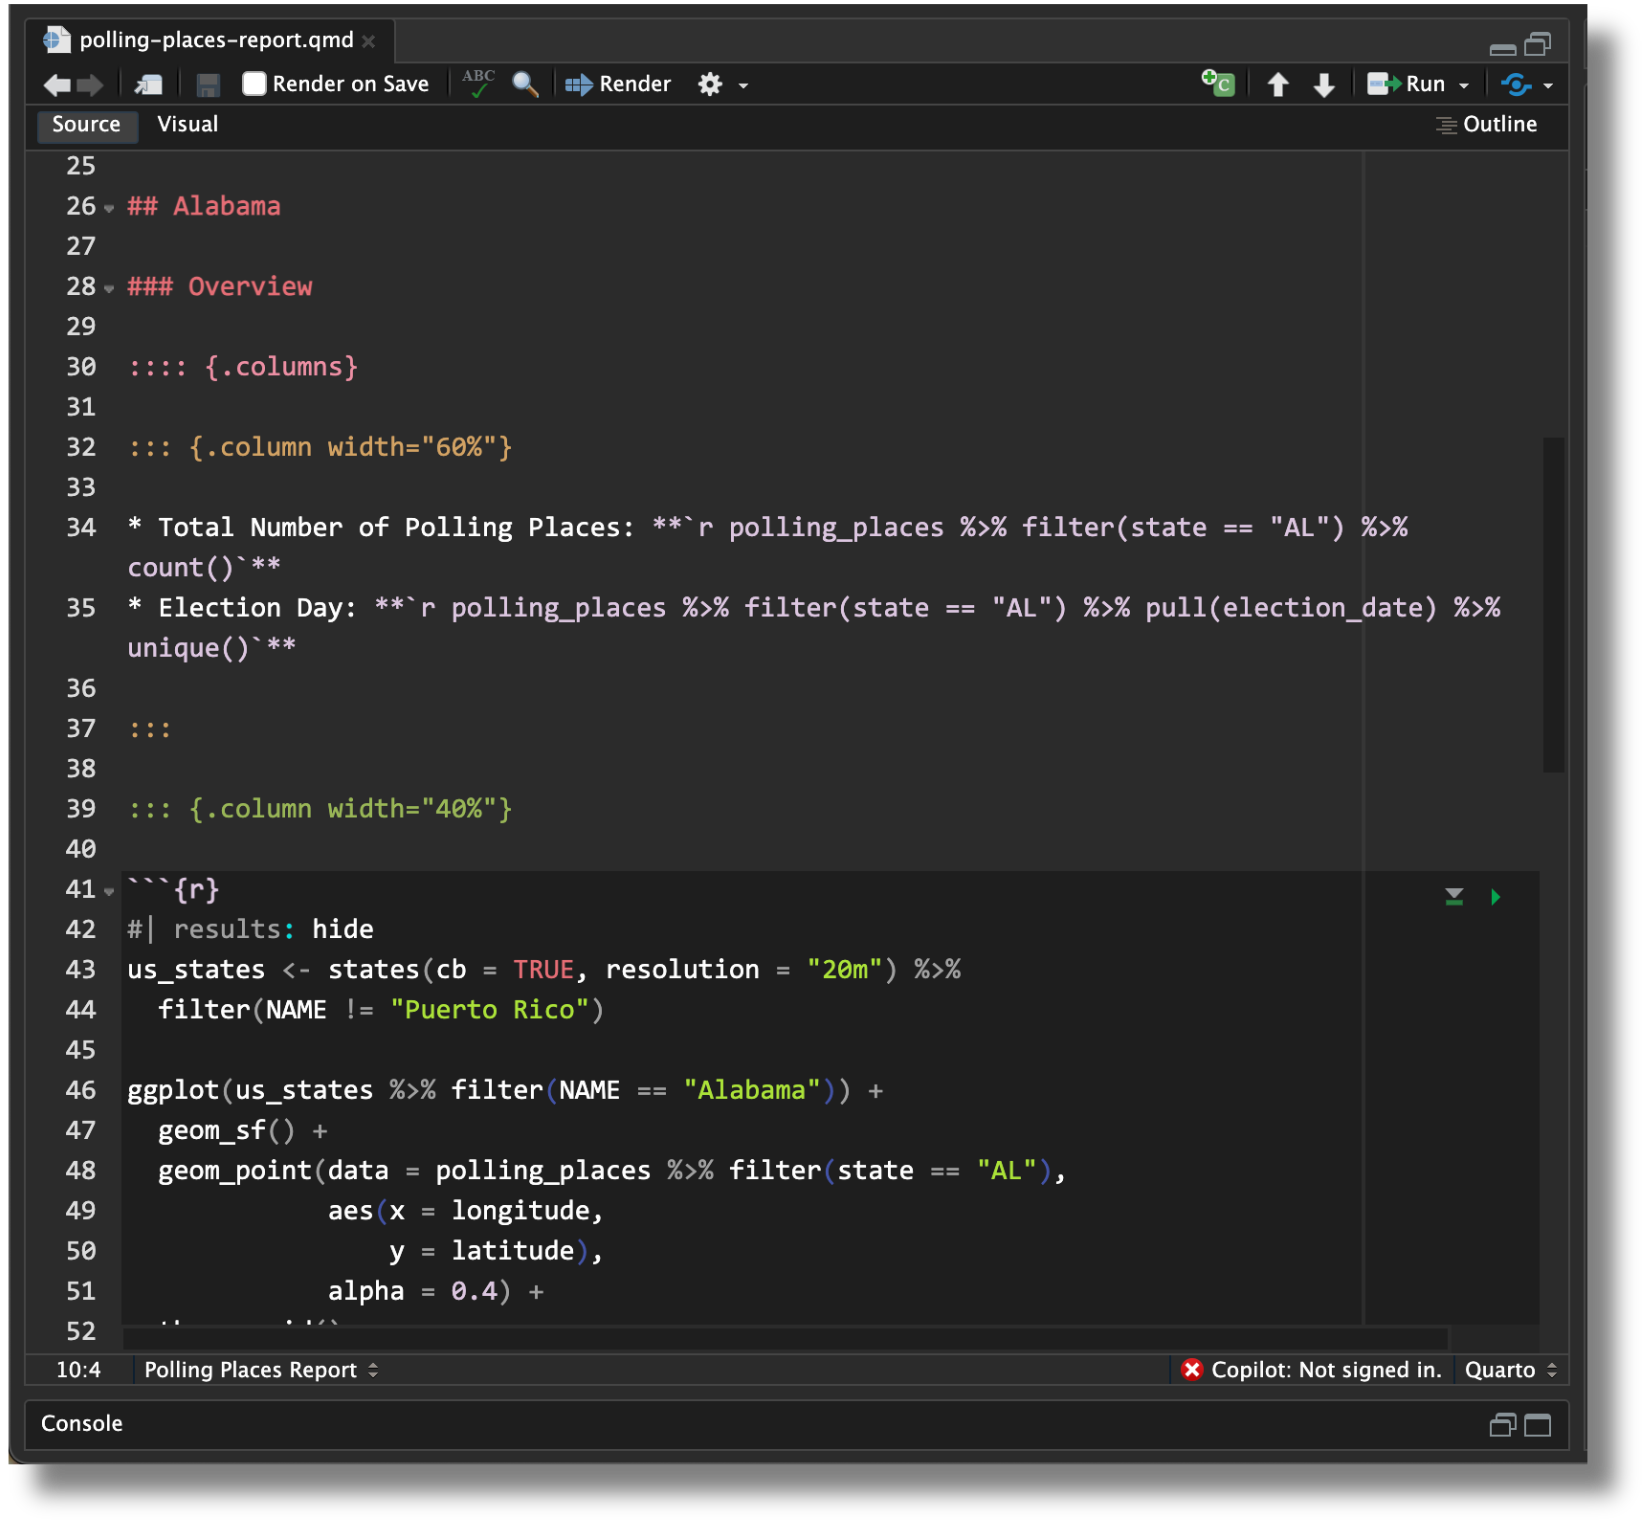
Agregue una figura con leyendas y etiquetas
- Agregar
#| etiqueta: fig-a etiquetas para referencias cruzadas - Utilice la opción de fragmento
#| fig-cap:para agregar un título a una figura o tabla
```{r}
#| label: "fig-statemap"
#| fig-cap: "Polling locations in the state"
#| results: hide
us_states <- states(cb = TRUE, resolution = "20m") |>
  filter(NAME != "Puerto Rico")

ggplot(us_states |> filter(NAME == "Alabama")) +
  geom_sf() +
  geom_point(data = polling_places |> filter(state == "Alabama"),
             aes(x = longitude,
                 y = latitude),
             alpha = 0.4) +
  theme_void()
```- Haga referencia a la figura en otras ubicaciones usando
\@fig-label.
Agregue código en la misma línea
- Agregue código en línea (dentro de Markdown) usando
`r` - Cuando se renderice el documento, se ejecutará la expresión entre los acentos graves.
Manual:
* Total number of counties: **65**
* Total number of polling places: **2075**
* Election Day: **2020-11-03**
Inline code:
* Total number of counties: **`{r} polling_places |> filter(state == "Alabama") |> distinct(county_name) |> count()`**
* Total number of polling places: **`{r} polling_places |> filter(state == "Alabama") |> count()`**
* Election Day: **`{r} polling_places |> filter(state == "Alabama") |> pull(election_date) |> unique()`**
Agregue notas de pie de página
- Agregue una nota al pie usando
[^1]dentro del texto y[^1]: Aquí está la nota al pie.para escribir la nota al pie.
In this report, we present a detailed overview of polling places in various counties across the United States, providing information on the total number of polling places and showcasing example locations for each county on election day.[^1]

[^1]: Data from https://github.com/rfordatascience/tidytuesday
Vamos a RStudio!
Abra el documento 01-rough-draft.qmd
Iterando sus reportes
Intro
¿Qué es un análisis de datos reproducible?
¿Qué es Quarto?
Empecemos con Quarto
Crear un reporte en Quarto
Iterando sus reportes
Dele estilo a sus reportes
Usar otros formatos
Usar co-pilot en R
¡Muchas gracias!
Observe cuánto tendríamos que repetir para cada informe.
- Creación manual de tablas para cada condado: ¡1881 condados!
- Creación manual de informes para cada estado del conjunto de datos: ¡39 estados!
Automaticemos las tablas de condado usando knitr::knit_child()
knitr::knit_child()le permite dividir su contenido en partes modulares más pequeñas- Implica tener un documento “secundario” como plantilla y ejecutarlo repetidamente con diferentes parámetros.
- El documento “principal” “teje” o incluye el resultado del documento secundario.
Preparemos el documento principal (“main”)
```{r}
#| results: hide
counties <- polling_places |> filter(state == "Alabama") |> distinct(county_name) |> pull()

expanded_child <- counties |>
  map(function(county) knitr::knit_expand("../_template.qmd", current_county = county))  |>
  flatten()

parsed_child <- knitr::knit_child(text = unlist(expanded_child))
```

`{r} parsed_child`
Preparemos el documento secundario (“child”)
En otro archivo llamado _template.qmd:
```{r}

### {{current_county}} COUNTY

* Total Polling Places: `{r} polling_places |> filter(state == params$state, county_name == "{{current_county}}") |> count()`
* Example Locations:
```
```{r}
polling_places |>
  filter(state == params$state,
         county_name == "{{current_county}}") |>
  head(6) |>
  select(name, address.x) |>
  kbl(format = "markdown")
```
Vamos a RStudio!
Abra el documento 02-iterate-report-knit-child.qmd
Automatizamos los informes estatales usando parámetros.
- Los parámetros se refieren a variables o valores que puede establecer en el encabezado YAML
- Estos parámetros se pueden utilizar para especificar valores que se utilizan en todo el documento.
- Usar parámetros significa que podemos crear copias del mismo informe para diferentes valores simplemente cambiando el parámetro en YAML.
Automaticemos los informes estatales usando parámetros.
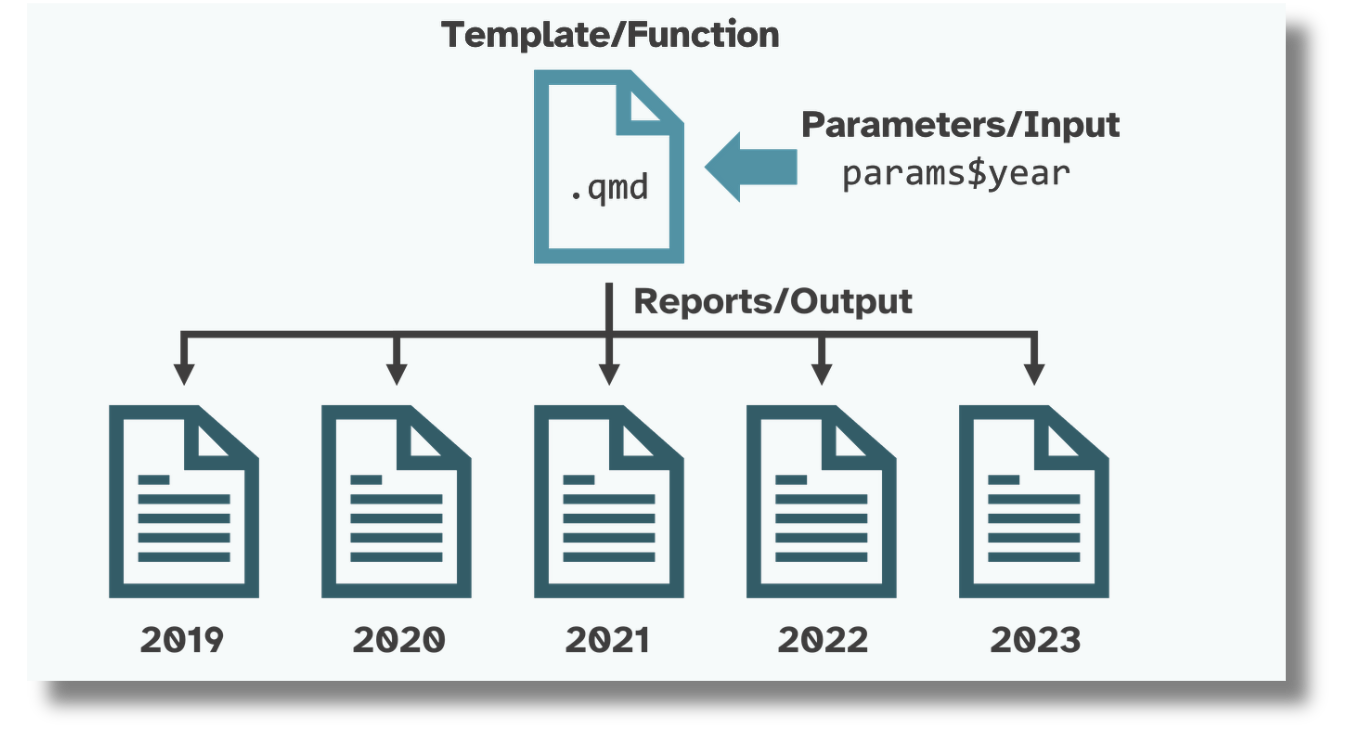
Fuente: Informes parametrizados con Quarto por Jadey Ryan
Edite el encabezado de YAML
- Use
paramsen el par key:value
Reemplace las variables codificadas con la variable params
- Use la notación
params$statecada vez que quiera llamar el valor
Reemplace las variables codificadas con la variable params
- Use la notación
params$statecada vez que quiera llamar el valor
```{r}
ggplot(us_states |> filter(NAME == params$state)) +
  geom_sf() +
  geom_point(data = polling_places |> filter(state == params$state),
             aes(x = longitude,
                 y = latitude),
             alpha = 0.4) +
  theme_void()
```
Note
Esto incluye el código en línea y el archivo “child” _template.qmd
Edite params en el YAML para obtener un reporte por estado
Renderizar el documento parametrizado
- Botón de renderizado en RStudio
- Quarto CLI:
quarto render polling-places-report.qmd -P estado:'California' - El paquete R en cuarto:
quarto::quarto_render()
Vamos a RStudio!
Abra el documento 03-iterate-report-parameters.qmd
Compile los 39 reportes
Opción 1:
- Cambie los
paramspara cada estado y renderice el documento. - Presentar el informe
- Cambie el nombre del archivo para que coincida con el parámetro.
- Repetir 39 veces
Compile los 39 reportes
Un reporte HTML por estado.
- Cree un marco de datos con columnas que coincidan con
quarto::quarto_render()
output_format: tipo de archivo (html, revelajs, pdf, docx, etc.)output_file: nombre de archivo con extensiónexecute_params: lista de parámetros con nombre
- Asigne cada fila:
purrr::pwalk(dataframe, quarto_render, quarto_render_args)
Cree el dataframe para iterar
```{r}
library(readr)
library(dplyr)
library(quarto)

polling_places <-
  readr::read_csv(here::here("data", "geocoded_polling_places.csv"))

polling_places_reports <-
  polling_places |>
  dplyr::distinct(state) |>
  dplyr::slice_head(n = 5) |>
  dplyr::mutate(
    output_format = "html",
    output_file = paste0(
      tolower(state),
      "-polling-places.html"),
    execute_params = purrr::map(
      state,
      \(state) list(state = state))) |>
  dplyr::select(output_file, execute_params)
```
Mapee sobre cada linea
Vamos a RStudio!
- Abra el documento
03-iterate-report-parameters.qmd - Abra también
_parameters-render.R
Dele estilo a sus reportes
Intro
¿Qué es un análisis de datos reproducible?
¿Qué es Quarto?
Empecemos con Quarto
Crear un reporte en Quarto
Iterando sus reportes
Dele estilo a sus reportes
Usar otros formatos
Usar co-pilot en R
¡Muchas gracias!
Agregue un Bootswatch theme
- Quarto incluye 25 temas o themes del proyecto Bootswatch
- En el encabezado YAML, agregue un tema usando
themeenhtml
Vamos a RStudio!
- Abra el documento
04-united-theme.qmd
Use extensiones
- Las extensiones son una manera muy poderosa de modificar y extender Quarto.
- El Awesome Quarto GitHub repo tiene una lista extensiva de extensiones disponibles.
- Por ejemplo, instale y utilice la extensión
sketchy quarto
Vamos a RStudio!
- Abra el documento
05-sketchy-theme.qmd
Use temas o custom themes
- Agregue un archivo
.cssor.scss(Syntactically Awesome Style Sheets) a su proyecto - Incluyalo en el encabezado YAML para usarlo en su reporte
/*-- scss:defaults --*/

@import url('https://fonts.googleapis.com/css2?family=Fraunces:opsz@9..144&family=Gilda+Display&display=swap');

$font-family-sans-serif: "Fraunces", sans-serif;
$presentation-heading-color: #446571;
$code-block-font-size: 0.6em;
$code-color: #5f5f5f;
$presentation-h2-font-size: 1.4em;
$link-color: #446571 !default;
Agregar un banner de título
- Incluya un bloque de título formateado al inicio del informe.
- Agregue al YAML usando
title-block-banner
Vamos a RStudio!
- Abra el documento
06-custom-theme.qmd
Usar otros formatos
Intro
¿Qué es un análisis de datos reproducible?
¿Qué es Quarto?
Empecemos con Quarto
Crear un reporte en Quarto
Iterando sus reportes
Dele estilo a sus reportes
Usar otros formatos
Usar co-pilot en R
¡Muchas gracias!
Agregar otros formatos al YAML
- Quarto puede representar múltiples formatos desde el mismo documento.
- Por ejemplo, agregue
pdfal YAML para representar las versiones HTML y PDF del informe.
Vamos a RStudio!
- Abra el documento
07-multiple-formats.qmd
Usar co-pilot en R
Intro
¿Qué es un análisis de datos reproducible?
¿Qué es Quarto?
Empecemos con Quarto
Crear un reporte en Quarto
Iterando sus reportes
Dele estilo a sus reportes
Usar otros formatos
Usar co-pilot en R
¡Muchas gracias!
Instalación + trabajo
Genere su propio documento reproducible en Quarto usando copilot.
¡Muchas gracias!
Intro
¿Qué es un análisis de datos reproducible?
¿Qué es Quarto?
Empecemos con Quarto
Crear un reporte en Quarto
Iterando sus reportes
Dele estilo a sus reportes
Usar otros formatos
Usar co-pilot en R
¡Muchas gracias!
¡Muchas gracias!
Por favor no duden en contactarme si tienen alguna duda:
Análisis de Datos Reproducible con R y Quarto